- 发布日期
Graphify:代码知识图谱如何进入编码 Agent 的上下文链路
- 作者
- 姓名
- Shoukai Huang
当编码 Agent 面对一个陌生代码库时,最先遇到的问题通常不是“不会写代码”,而是不知道应该先读哪些代码。它需要从入口文件开始搜索,再根据 import、调用关系和目录结构逐步扩展上下文。问题在于,文件系统提供的是位置,代码图谱提供的是关系。
Graphify 是一个把代码库、文档和其他输入转换成可查询知识图的开源工具。对编码 Agent 来说,它更像一张代码关系地图:先帮 Agent 找到相关文件和符号,再回到源码理解、修改和测试。这里的“结构预检索层”是本文根据接口和内部验证做出的判断,不是 Graphify 对 Agent 效果的官方结论。
下面的内容来自一次内部验证。使用的是 2026 年 10 月 23 日的 Graphify 版本(graphifyy 0.9.95),测试项目是 ApFramework 博客。为了先看清代码分析能力,只取了 app/、components/、lib/、scripts/、package.json 和 tsconfig.json,没有把整个项目都放进去。
一、从“读哪些文件”到“代码如何连接”
传统搜索适合回答“某个字符串出现在哪些文件”。但编码 Agent 还会遇到另一类问题:一个页面依赖了哪些组件?一个服务怎样连到数据库?两个模块之间经过了哪些调用?这些问题需要同时看文件、符号和它们之间的关系。
如果 Agent 直接把整个文件读进来,信息可能太多;只靠向量搜索,又可能找到“意思相近”但并不关键的文件。代码知识图谱先把文件、符号和关系整理出来,给出一张可以沿着关系查找的地图。
这张地图不能代替源码。它先解决的是“从哪里开始看”和“哪些地方有关联”。真正要改函数时,Agent 还是要打开源文件,读懂实现,再跑测试。
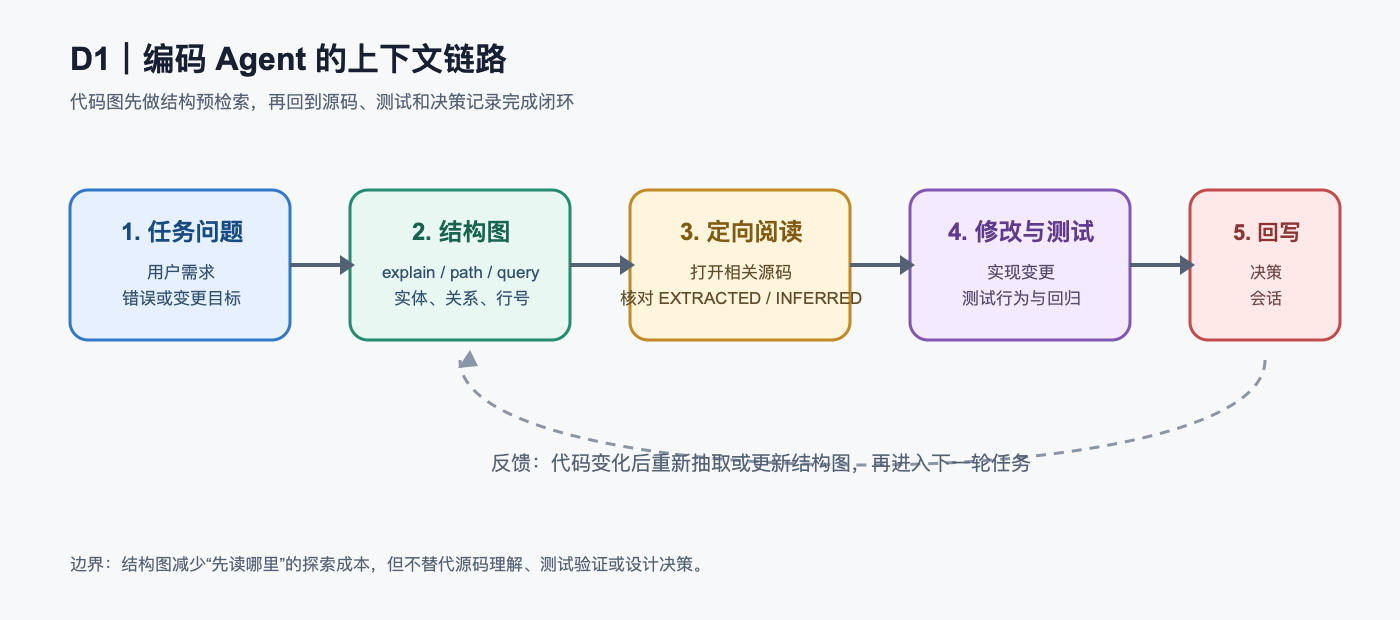
图 1:Graphify 更适合作为结构预检索层,先帮助 Agent 定位入口和关系,再回到源码、测试与决策记录完成闭环。
二、代码知识图谱记录什么
Graphify 用 tree-sitter AST 读取代码结构。代码建图可以在本地完成,不必调用 LLM;文档、图片、视频等内容的语义处理,则可能需要配置相应的后端。
默认构建流程通常产生三个主要文件;如果使用 --no-viz 等选项,输出可能不同:
graph.html:可以在浏览器中查看和搜索的交互式图;GRAPH_REPORT.md:对高连接节点、社区和关键关系的摘要;graph.json:供命令行、Agent Skill 或 MCP 查询的完整图数据。
可以把 graph.json 想成一张“代码关系表”。它主要记录两类东西:代码库里有哪些节点,以及节点之间有什么关系。比如,一个页面函数是一个节点,一个组件文件也是一个节点;页面导入组件,就是它们之间的一条边。
下面是一个简化的结构示意,帮助理解它大概长什么样。字段会随 Graphify 版本和节点类型变化,这段 JSON 不是本次内部验证生成文件的逐字内容:
{
  "graph": {
    "schema_version": "...",
    "graphify_version": "0.9.95"
  },
  "nodes": [
    {
      "id": "app/blog/[...slug]/page.tsx::Page()",
      "type": "function",
      "name": "Page()",
      "file": "app/blog/[...slug]/page.tsx",
      "line": 80
    },
    {
      "id": "components/MDXComponents.tsx",
      "type": "file",
      "name": "MDXComponents.tsx",
      "file": "components/MDXComponents.tsx"
    }
  ],
  "links": [
    {
      "source": "app/blog/[...slug]/page.tsx::Page()",
      "target": "components/MDXComponents.tsx",
      "relation": "imports_from",
      "provenance": "INFERRED"
    }
  ]
}
把它换成人话就是:
Page()                         一个页面函数
MDXComponents.tsx              一个组件文件
Page() --imports_from-->       MDXComponents.tsx
graph.json 是给程序和 Agent 用的,graph.html 是给人点着看的,GRAPH_REPORT.md 更像一份自动整理出来的摘要。Agent 通常不会把整个 JSON 全部读进上下文,而是用 explain、path 或 query 先取出和当前问题有关的部分,再回到源码阅读。
图中的节点可以是文件、类、函数、方法、依赖包或文档对象,边则表示 imports、calls、inherits、references 等关系。Graphify 还给边添加了两类标签:EXTRACTED 表示关系可以在源代码中直接找到,INFERRED 表示关系是通过解析和跨文件 resolution 推导出来的。
这两个标签把“工具直接读到的内容”和“根据结构推出来的关系”分开了。Agent 可以先把推断关系当作线索,再回到源码核对。
图谱也有边界。它通常不保存完整的函数正文,也不会自动记录所有架构意图、历史决策和会话过程。一条 calls 边只能说明两个符号之间有调用关系,不能说明为什么要这样调用。
三、Graphify 现在是什么样
这次检查使用的版本是 graphifyy 0.9.95,命令仍然叫 graphify,需要 Python 3.10 及以上。
现在的 Graphify 不只是运行一次命令、生成一张图:
| 层次 | 当前能力 | 对 Agent 的意义 |
|---|---|---|
| 结构抽取 | tree-sitter AST、多语言代码解析 | 获得文件和符号关系 |
| 图产物 | graph.json、HTML 和报告 | 保存可查询的结构结果 |
| 查询接口 | explain、path、query | 按问题读取局部结构 |
| 能力接入 | Skill、项目级安装、MCP | 让 Agent 能调用图,而不只是人查看 |
| 持续维护 | hooks、增量更新、图版本标记 | 让结构图随代码变化维护 |
| 输入扩展 | 文档、PDF、图片、视频等 | 将部分外部上下文关联到代码图 |
这些能力让代码图可以接入 Agent 的工作流程。图提供结构信息,Skill 说明怎么调用,MCP 或命令行提供入口。不过,Skill 安装不等于建立了 MCP 连接,hooks 是否生效也要看具体平台和安装状态。源码和测试仍然是最后的依据。
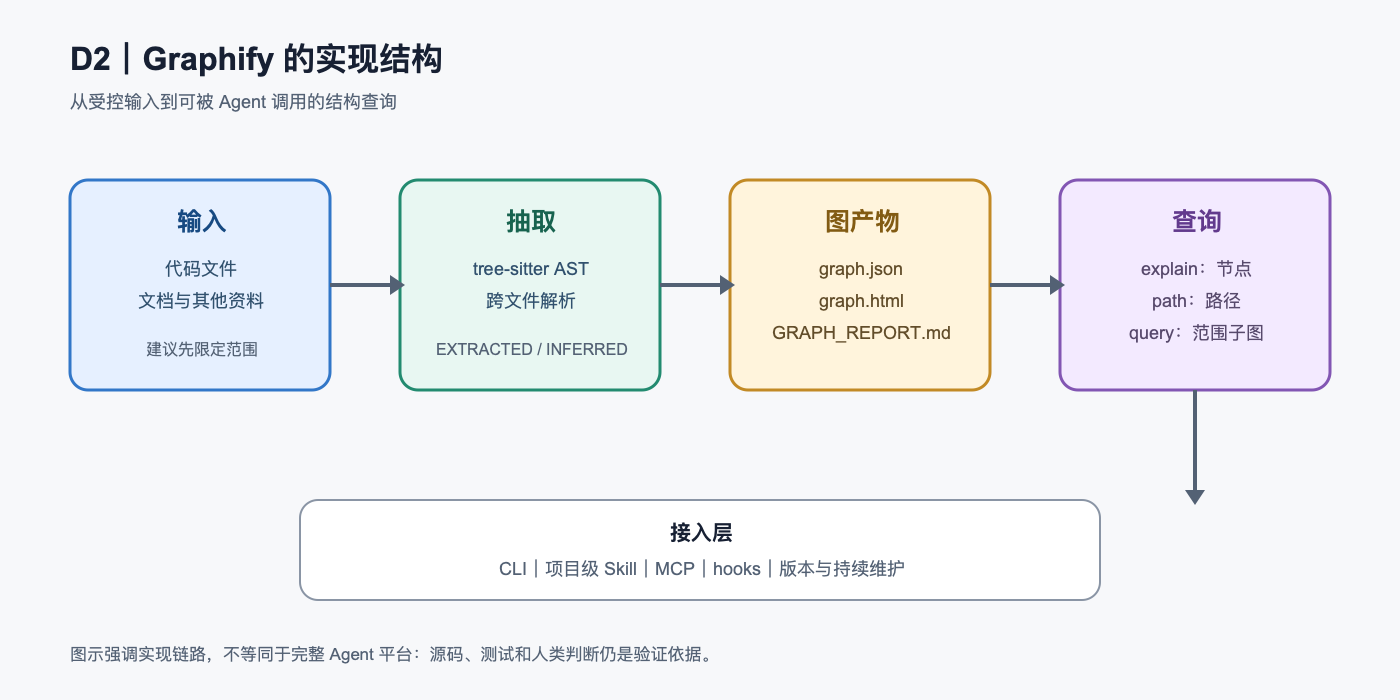
图 2:Graphify 的实现链路示意。接入层表示公开实现中的 CLI、Skill、MCP 和 hooks 入口,不等于本次局部实验已验证所有入口。
四、三个查询命令分别解决什么问题
1. explain:解释一个节点
explain 用来回答“这个符号是什么、和哪些东西相连”。输出通常会带上来源文件、行号、连接数和相关关系。
如果名称不唯一,Graphify 不会替用户随便选一个。本次输入:
graphify explain "Page()" \
  --graph graphify-out/graph.json
结果给出了 5 个候选节点,分别位于不同的页面文件中。换成带路径的写法:
graphify explain \
  "app/blog/[...slug]/page.tsx::Page()" \
  --graph graphify-out/graph.json
这次定位到了博客文章详情页源文件第 80 行的 Page()。
代码库里的 Page、Client、Config 可能在多个文件甚至文档中出现。工具要求补上路径,至少不会悄悄选错。
2. path:追踪两个节点之间的关系
path 用来回答“两个东西是怎么连起来的”。这次查的是页面函数到 MDX 组件的路径:
graphify path \
  "app/blog/[...slug]/page.tsx::Page()" \
  "components/MDXComponents.tsx" \
  --graph graphify-out/graph.json
返回了一条两跳路径:
Page() <--contains-- blog/[...slug]/page.tsx
      --imports_from--> MDXComponents.tsx
这条路径当然不是博客渲染的全部细节,但它给出了一个明确的阅读顺序:先看页面入口,再看导入的 MDX 组件。比起在整个项目里搜索“博客渲染”,这个结果更容易直接使用。
3. query:围绕问题返回范围受控的子图
query 适合处理范围更大的问题,例如:
graphify query "which components connect to the blog rendering pipeline" \
  --graph graphify-out/graph.json \
  --budget 1000
这次查询找到了 67 个相关节点,但 --budget 1000 只展示了 47 个,并给出 TRUNCATED 提示。把预算调到 1447 后,结果仍提示需要更高预算。也就是说,query 返回的是受预算限制的一部分关系,不是一份完整架构文档。
这对 Agent 的用处在于,结果不会无限扩大,而且会明确提示可能被截断。接下来可以提高预算、缩小问题,或者增加关系过滤。
五、在真实项目中做一次受控验证
这次用的是 ApFramework 博客仓库。先尝试把整个工作树交给 Graphify,但项目里有依赖、构建产物和大量静态资源,约 3.2GB,完整扫描没有跑完。
所以,做这类检查前最好先划清输入范围。否则扫描出来的很可能是项目环境的大小,而不是代码分析能力。
随后把输入缩小为项目的核心源码目录和两个配置文件:
app/
components/
lib/
scripts/
package.json
tsconfig.json
运行:
graphify extract \
  ./graphify-apframework-input \
  --code-only \
  --no-cluster \
  --out ./graphify-apframework-result
实际输出为:
[graphify extract] found 64 code, 0 docs, 0 papers, 0 images
[graphify extract] AST extraction on 64 code files...
[graphify extract] wrote .../graph.json — 373 nodes, 682 edges (no clustering)
这几个数字只说明这次选中的文件和这次运行,不能拿来代表整个 ApFramework 项目,也不能用来判断性能。因为用了 --no-cluster,社区聚类报告也不在这次检查范围内。
后来我在博客页面文件里加了一行不改变逻辑的注释,再用另一个输出目录重新抽取,结果还是 373 个节点、682 条边。这只能说明这次改动没有改变抽取结果。它不能算 graphify update 的增量性能测试,因为前后用的是两个独立的 extract 输出目录。
这次检查的步骤很简单:
- 先排除依赖和构建产物,选出要看的代码;
- 用 code-only 模式建图,记录文件、节点和边;
- 用
explain看节点能不能定位; - 用
path看跨文件关系; - 用
query看结果范围是否受预算控制; - 回到源码核对关键关系。
graphify update、检索质量、Token 成本和修改正确率,这次都没有继续验证。
六、代码图是 Agent 记忆的一层,不是全部记忆
把 Graphify 称为“代码记忆”没有问题,但要说清楚它记住的是什么:文件、符号、依赖,以及它们之间的连接方式。
编码 Agent 还需要其他几类记忆:
| 记忆层 | 主要回答的问题 | 典型载体 |
|---|---|---|
| 代码结构记忆 | 代码现在如何连接? | AST-derived graph、graph.json |
| 来源知识 | 外部资料表达了什么? | raw、wiki、文档 |
| 会话记忆 | 上一次发生了什么? | logs、chats、resume |
| 决策记忆 | 为什么这样设计? | ADR、永久笔记、PR 评论 |
| 偏好与规则 | 项目通常应该怎么做? | rules、skills、项目记忆 |
| 相似性检索 | 哪些文本与当前问题相似? | 向量索引 |
这些信息各管一部分。图查询能告诉 Agent 页面和组件之间有 imports_from 关系,却不能告诉它团队为什么选这个组件;向量检索能找到相似的设计文档,却不一定能给出调用路径;会话日志记得发生过什么,但不等于当前代码的结构。
实际使用时,可以先用结构图找入口和关系,再读源码补齐细节,用测试确认行为,把决策和会话记录留下来。Graphify 能减少的是找代码的成本,不是所有上下文成本。
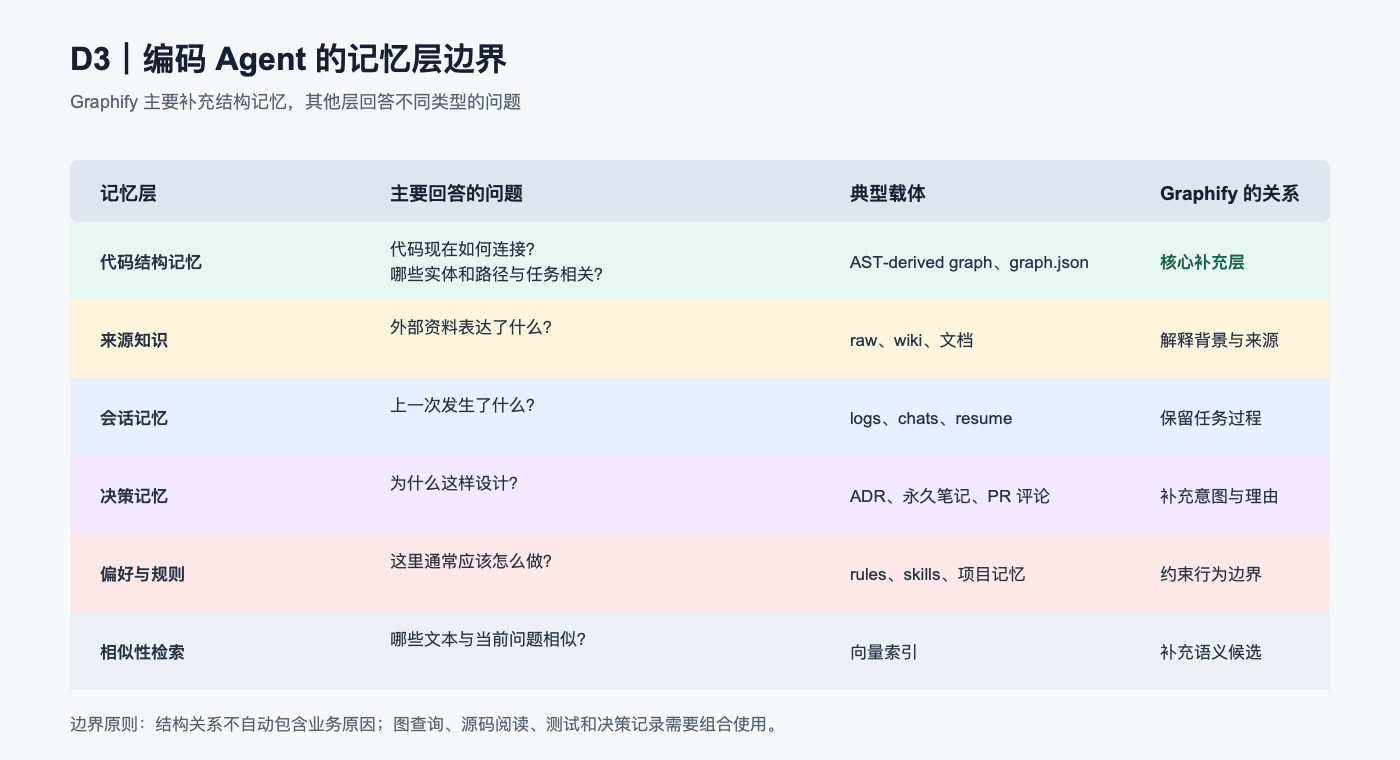
图 3:不同记忆层的边界对比。Graphify 主要补充代码结构记忆,不能自动提供来源背景、会话过程、设计理由或项目规则。
七、从一次性建图到上下文编排层
Graphify 这几年的变化,主要在四个方面。
第一,输出不再只有可视化图。graph.html 适合人浏览,graph.json 则可以被命令、Skill 或 MCP 查询。
第二,工具增加了 Agent 接入方式。graphify install、项目级 Skill、MCP 和部分平台的 hooks,都可以让“先查图”变成工作流程的一部分。但不同平台的能力不一样,不能理解成安装后所有文件搜索都会自动被拦截。
第三,边上增加了来源标签。EXTRACTED 和 INFERRED 能帮助调用方区分直接抽取的关系和推导出来的关系,但它们不是统一的概率分数。遇到 INFERRED,还是要回源码核对。
第四,知识图开始考虑持续维护。图里有 schema/version 标记,也提供更新命令和 hooks 相关能力。图如果长期不更新,Agent 看到的入口就可能已经过时。
这些能力并不等于 Graphify 已经是完整的编码 Agent 平台。更准确地说,它负责把代码库整理成一个可以导航、追踪和查询的结构层。
八、边界:一次验证不能证明什么
这次能确认的事情很有限:选中的源码可以被抽成包含节点和边的图;explain 能定位节点,也会暴露名称歧义;path 能返回跨文件路径;query 会按 token 预算返回部分关系;关系标签和源码位置方便后续核对。
但它没有证明以下事情:
- 没有证明完整 ApFramework 项目能够在当前环境中顺利完成构图;
- 没有证明 Graphify 能自动提高代码修改正确率;
- 没有证明一次局部查询就能还原完整架构意图;
- 没有独立复现项目方 README 中的 benchmark 或 Cloud 节省比例;
- 没有验证
graphify update在同一缓存目录中的增量性能; - 没有证明 INFERRED 关系不需要人工或测试核对。
边界也很清楚:图能帮助 Agent 更快找到该读的地方,但找到代码不等于理解原因,理解原因也不等于修改一定正确。
结语:先给 Agent 一张可追溯的地图
Graphify 的价值不只是把代码画成网络图,而是给 Agent 一个可以查询的结构入口。“我应该先看哪里”可以先用 explain、path 和 query 找到线索,再回到源码和测试确认。
在项目里使用时,可以先选一小块源码:先建图、查询,再回源码核对。确认这套关系对当前项目有帮助后,再考虑接入 Skill、MCP、hooks 和持续更新。
代码知识图谱可以作为编码 Agent 上下文中的一层结构记忆,但不是完整的记忆系统。它回答“代码现在怎样连接”,其他记忆层回答“发生过什么”“为什么这样决定”以及“这里通常应该怎么做”。实际使用时,需要把这些信息接起来。