
- 发布日期
从 OpenTelemetry 到受控自治:SRE 可观测性的五阶段演进
- 作者
- 姓名
- Shoukai Huang
- 身份
- Software Architect · Indie Developer
把 AI 接入生产运维,常见的设想是让模型读取告警、检索日志,甚至自动修复故障。但模型能否作出有用判断,首先取决于遥测信号是否完整、能否与服务及变更关联;它能否采取行动,则取决于模型之外是否有明确的权限控制和结果验证。
Aman Kohli 在《From OpenTelemetry to Autonomous SRE》中提出了五阶段路线:统一遥测、建立运营上下文、引入只读 AI 调查、观测 LLM 应用自身,最后再开放受策略约束的修复。这不是某个产品的部署清单,而是逐步建设生产运维能力的路径:先让系统状态可见,再审慎地赋予系统行动能力。
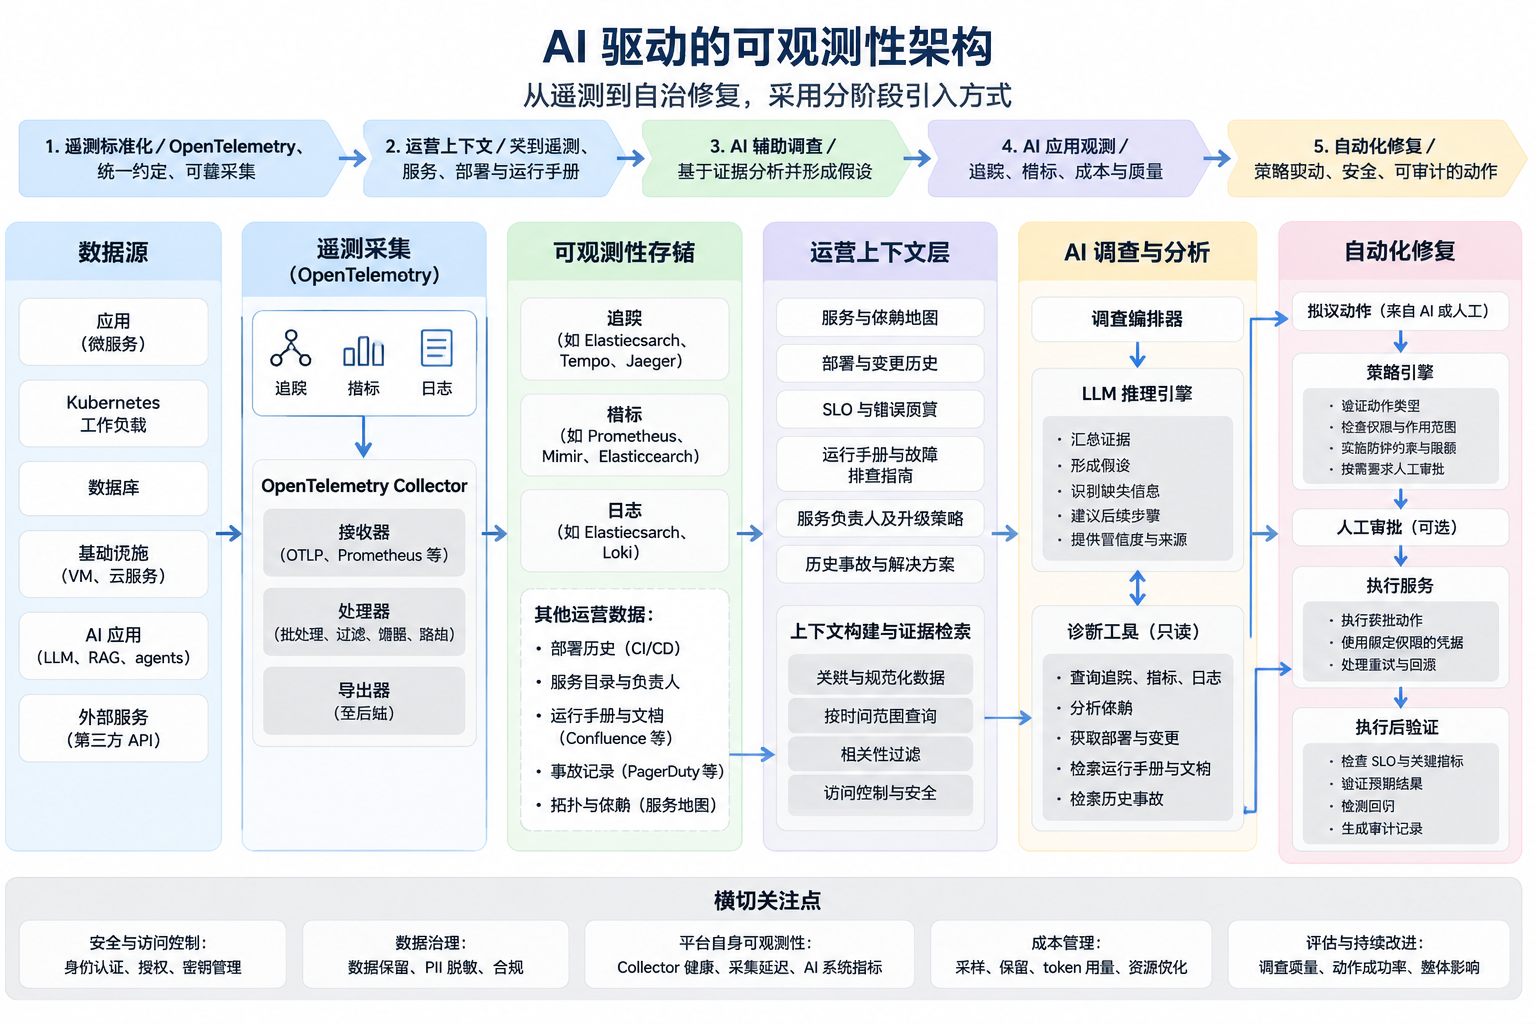
AI 驱动可观测性架构(翻译来源 Aman Kohli,《From OpenTelemetry to Autonomous SRE》)
一、先统一遥测,让请求路径连得起来
生产系统由多个服务、数据库和基础设施组件构成。若团队各自选择埋点方式、服务命名和字段语义,局部图表或许仍能说明单个组件的状态,却难以还原一次请求如何穿过整条服务链。可观测性建设的起点,是让不同服务产生的信号能够被共同识别和关联。
OpenTelemetry(OTel)提供生成、采集和导出遥测数据的统一框架。它的 Collector 通过 pipeline 处理数据:receivers 负责接收,processors 可按配置处理或筛选,exporters 则将数据送往目标端。OTel 文档将 traces、metrics 和 logs 作为不同信号类型配置 pipeline。统一采集接口和信号语义,并不意味着所有团队必须使用同一个可观测性后端。
跨服务调查还需要上下文传播。上游服务调用下游服务时,trace context 可以随请求传递,使下游 span 与上游 span 归入同一条 trace。日志也可以记录 trace 和 span 标识,方便从错误日志回溯到对应的请求路径。这样,排查者看到的不只是彼此孤立的服务指标,还能定位延迟或错误出现在请求链路的哪个环节。
不过,trace 呈现的是已采集到的执行关系,只能提供关联和诊断线索,不能单独证明某次部署导致了故障。原文举例说,部署时间与延迟上升同时出现,可以帮助确定调查方向;若要判断两者是否相关,还需比较变更前后的数据库行为、连接等待和请求路径。
遥测管道本身也需要监控。接收量正常,不代表数据已经送达后端:Collector 的内存保护机制可能拒收数据,后端变慢可能造成导出队列持续积压,队列耗尽后还可能无法接收新的信号。OpenTelemetry 的扩容指南提醒,如果瓶颈出在遥测数据库或 Collector 到后端的网络,单纯增加 Collector 可能无济于事,甚至会进一步加重后端压力。因此,评估采集可靠性时,要同时观察入口、处理和导出状态。出现数据丢失或积压后,应先定位受限环节,再决定是否扩容。
这一阶段的验收重点,不是接入了多少服务,而是关键请求路径能否连续追踪、采集缺口和摄取失败是否可见,以及这些信号能否支持后续调查。Collector 不会替团队定义字段语义;服务名、资源属性、语义约定和 trace context 仍需应用团队与平台团队协调。它能改善信号的互操作性,却不会自动统一业务语义,也不能直接识别根因。
二、把遥测放进运营上下文
一条 trace 能显示请求经过哪些服务、在哪个 span 上变慢,却未必能回答服务最近发生了什么变更、由谁负责,或当前 SLO 目标是什么。调查还需要服务依赖关系、部署与配置历史、SLO 和错误预算、runbook、历史事故记录及服务 owner 等信息。
运营上下文将“发生了什么”放回“系统如何运行”的背景中。比如订单接口变慢,trace 可能只将问题定位到库存服务的一次慢调用;依赖关系可以显示库存服务还受哪些下游影响,部署历史则帮助确认异常时间窗内发生过哪些变化。SLO 和错误预算用于判断影响程度,owner 与升级策略指明由谁接手。runbook 和历史事故可以提供待核对的操作步骤,但仅仅找到相似事故,并不能证明本次故障原因相同。
对 AI 调查来说,这也是上下文工程问题。模型不需要未经筛选的全部日志和文档,而需要围绕当前事故挑选、整理并标明出处的材料。构建上下文时,应对齐服务名与依赖关系、限定事故时间窗、过滤无关内容,并保留证据来源。缺少 owner、时间范围或服务关系,即使材料很多也可能只是噪声。上下文还应标明资料的更新时间和适用范围,避免过期的 runbook 或错误的依赖图误导调查。检索同样要遵守使用者原有的权限边界,不能为了让模型“看全”而扩大访问范围。
原文在 “A typical investigation pipeline” 后只有图示占位,没有可读取的流程细节。本文加入的架构图来自用户补充的另一张参考图,用于说明一种组件分层方式;它既不是对原文缺失流程图的复原,也不是 OpenTelemetry 规定的标准架构。两者能够确认的共同点仅在于:应将遥测与运行文档、服务依赖和变更历史结合起来,供工程师及后续 AI 调查使用。
三、先让 AI 只读调查
只有在信号和上下文可以关联后,第三阶段才引入 LLM 辅助调查。原文举例:结账服务的 P95 延迟和错误率同时上升,CPU 使用率仍正常,而库存依赖刚刚发布了新版本。调查编排器可以据此查询相关 trace、指标和日志,检查服务依赖与部署变更,再将带有时间范围和出处的材料交给模型。参考图把诊断工具设为只读,由 LLM 推理组件汇总证据、提出假设、指出信息缺口并建议后续步骤。这样,“查到了什么”和“如何解释”各有边界,工程师也更容易回溯证据。
示例中的“连接池等待上升”只是调查线索。模型不能仅凭时间上的先后关系就确认根因。调查报告应明确列出主要假设、支持它的 trace 或指标、其他可能解释、尚缺的信息,以及下一步如何验证。例如,可以比较部署前后的查询数量和连接池行为。报告是否有用,不取决于模型语气有多肯定,而取决于工程师能否根据其中的证据复核结论。
这一阶段应维持只读。编排器可以查询遥测、部署记录和依赖信息,但不应同时拥有重启服务或修改配置的权限。要确认调查能力确实只读,需要检查工具能调用哪些 API、能访问哪些服务,以及查询范围,而不能只看角色名称。这样可以限制错误假设的影响,也能先评估调查质量,再决定是否扩大权限。
评估不应只看回答是否流畅。可以先检查证据引用能否回到真实 trace 或变更记录、调查轨迹是否覆盖必要步骤且没有无效循环,以及最终假设是否得到后续证据支持。随后再看经验证诊断耗时、人工接受或驳回的原因,以及调查遗漏了什么。选用工具、调查步骤、任务完成情况和事故结果属于不同评估层次,不能由一个模型评分概括。原文建议将结果与历史基线比较,但没有给出经过验证的改进幅度。
四、为 LLM 应用本身建立可观测性
模型参与调查后,它所在的应用也成为生产链路的一部分。一个 RAG 请求可能依次经过文档检索、上下文构造、一次或多次模型调用,以及外部工具执行。若只记录入口 HTTP 请求,就看不出耗时来自检索、模型还是工具。将这些操作放入同一条可关联的 trace,并用指标观察延迟、错误和 token 用量,才能分别分析单次请求与长期成本趋势。
原文用一个四秒响应说明端到端追踪的作用:检索文档可能耗时两秒,模型处理约 700 毫秒。这只是说明问题的示例,并非通用性能基准。将检索、模型调用和工具执行分别记录为可关联的 span,有助于定位实际耗时和故障环节;指标则用于汇总延迟、错误和用量趋势。是否满足运维任务要求,还需结合任务评估判断。
OpenTelemetry 的 GenAI 语义约定为模型推理、Agent 调用、工具执行、检索,以及相关指标和事件提供了一套共同词汇,方便不同实现描述这些操作。不过,官方仓库目前将其标记为 Development,规范仍在演进。接入时应记录所用的约定版本,不要将当前字段名称视为稳定不变的接口。
遥测也可能包含敏感数据。模型名称、token 用量和调用耗时,与用户输入、系统提示、工具参数和模型输出并非同一类信息。GenAI 语义约定描述了输入和输出事件的表示方式,但这不意味着必须记录原始内容,也没有为所有实现提供统一的默认脱敏策略。输入或输出可能包含个人信息、凭据或业务数据,因此是否采集、谁能访问、如何脱敏以及保留多久,都需要纳入数据治理。采集更多内容并不必然让诊断更准确,尤其是在访问和保留边界尚未明确时。
还要区分运行过程与任务质量。可观测性可以记录请求经过哪些步骤、花费多少时间和资源,却不能单独证明答案正确、根因成立或任务已完成。语义质量仍需通过任务级校验、回放评估或人工抽查来判断,不能由一条完整 trace 代替。比如,调查 Agent 成功调用日志检索工具,只能说明工具调用完成;它是否引用了正确的时间窗、是否遗漏关键依赖、建议是否经验证解决了告警,还要看任务结果。将执行轨迹与评估结果关联,才能进一步判断问题出在检索、推理还是执行环节。
五、把修复动作交给受约束的执行系统
到第五阶段,系统才从“模型建议做什么”转向“实际执行动作”。可以先自动收集诊断信息、创建事故工单或通知负责人。重启 workload、调整副本数等会改变生产状态的操作,则需事先定义触发条件、资源范围和失败处理方式。参考架构将流程分为拟议动作、策略裁决、按需人工审批、执行服务和执行后验证。这样的分层让每一步的输入、决定与结果都可检查,也避免让模型直接持有生产凭据。
关键是将推理与执行分开:模型提出候选动作,独立的策略层根据身份、资源、操作类型和上下文判断是否允许,再由受控执行器执行获准的动作。策略可以限定 namespace 和资源范围,设置副本上限与冷却时间,并要求高风险操作经过人工审批。Open Policy Agent 的文档也将策略决策与策略执行区分开来:策略引擎返回决策,调用方负责执行或拒绝。若存在绕过策略检查的执行入口,仅增加策略服务并不能形成有效控制。参考图列出的权限和范围检查、防护措施与限额,是策略设计需要考虑的维度,不代表任何通用产品都已自动提供这些安全保障。
权限语义还取决于具体平台。以 Kubernetes 为例,官方建议遵循最小权限原则,并尽可能将权限限制在 namespace 范围内;通配符可能使权限覆盖未来新增的资源类型。有些看似只读的权限也未必安全:对 nodes/proxy 的 get 可以访问 Kubelet API,不等于普通读取。因此,审查“只读调查”时,应核对具体 API 权限,不能只依据角色名称判断。
不可逆或影响较大的操作,是否需要审批应由确定性规则决定,而不是交给模型自行判断。模型可以解释理由、提供证据或建议回滚,但授权决定应独立于模型推理。审批、操作限额、冷却期和审计记录共同限定系统能做什么、何时能做,以及事后如何追查。
假设系统将部署副本数从四个扩到六个,副本数变化只能证明动作已执行,不能说明事故已经解决。执行后,应在约定的观察窗口内检查延迟和错误率是否回到服务目标范围,同时关注依赖服务和相关 SLO,确认没有引入新的回归。如果指标没有按预期变化,或出现新的异常,应停止叠加动作,并按预先定义的规则回滚或升级给工程师。事先约定成功条件、观察窗口和停止条件,再记录实际动作、验证结果及回滚信息,才能让修复过程可检查、可审计。
用基线判断阶段是否带来帮助
原文建议用运营结果衡量这条路线,而不是数已经上线多少 AI 功能。指标可以按阶段观察:遥测是否完整、摄取是否可靠;调查从告警到经验证诊断用了多久、假设有多少得到核实;LLM 应用的请求链性能、可靠性、质量和单位成功任务成本如何;修复动作是否成功获准并达到预期,策略违规和回滚出现得是否频繁。事故解决时间也可以作为更高层的结果指标,但解释时要考虑事故类型、严重程度及同期发生的其他变化。
这些指标都需要在目标环境中定义基线、成功判据和归因方法。例如,“AI 假设准确率”必须说明由谁根据什么证据判定;自动修复成功率也要明确,衡量的是动作执行成功,还是服务指标在观察窗口内恢复。成本最好按成功完成的调查或任务计算,而不只看单次模型调用的 token 数,否则缓存、重试、检索和人工返工等开销可能被漏掉。若指标口径不一致,看似可比较的数字实际衡量的可能是不同事件。
这五个阶段不必机械地转化为组织成熟度等级,团队可以根据风险调整建设节奏。不过,每次扩大权限前,都应确认已有能力足以支撑下一步:信号能否关联、上下文是否及时、调查能否复核、动作能否授权、结果能否验证。能够解释某个事件,并不意味着应立即允许模型修改生产系统;从只读调查转向写入操作,还需要单独完成安全与运行验收。
参考来源
- Aman Kohli, From OpenTelemetry to Autonomous SRE: A 5-Phase Roadmap for AI-Driven Observability。五阶段及文中场景与指标建议均归属于原文作者。
- OpenTelemetry, Collector Architecture。
- OpenTelemetry, Scaling the Collector。
- OpenTelemetry, Context Propagation。
- OpenTelemetry, Semantic Conventions for Generative AI Systems。当前状态为 Development,核对于 2026-11-14。
- Kubernetes, Role Based Access Control Good Practices。
- Open Policy Agent, Policy Decoupling。
- ApFramework, 上下文工程:从提示工程到智能体时代的关键技术。
- ApFramework, 构建 AI 智能体应用(五):生产监控与可观测性实战。