Agent Skill · 图书阅读
Open Context Book Reader
非虚构图书阅读 Skill
为非虚构图书做读前定位、读后阅读地图和可回查的精选笔记,支持从 PDF、EPUB 等本地文件提取内容。
01 / 场景
先确认读到了哪些部分
面向非虚构图书,尤其适合 AI、科学、技术与哲学。可读取本地 PDF、EPUB、TXT、Markdown 和 HTML,并检查提取质量与章节覆盖。
只有书名、简介或目录时,会提供明确标记的初步定位;只有部分章节时,也不会把局部阅读说成通读全书。
02 / 能做什么
从输入到可用的结果
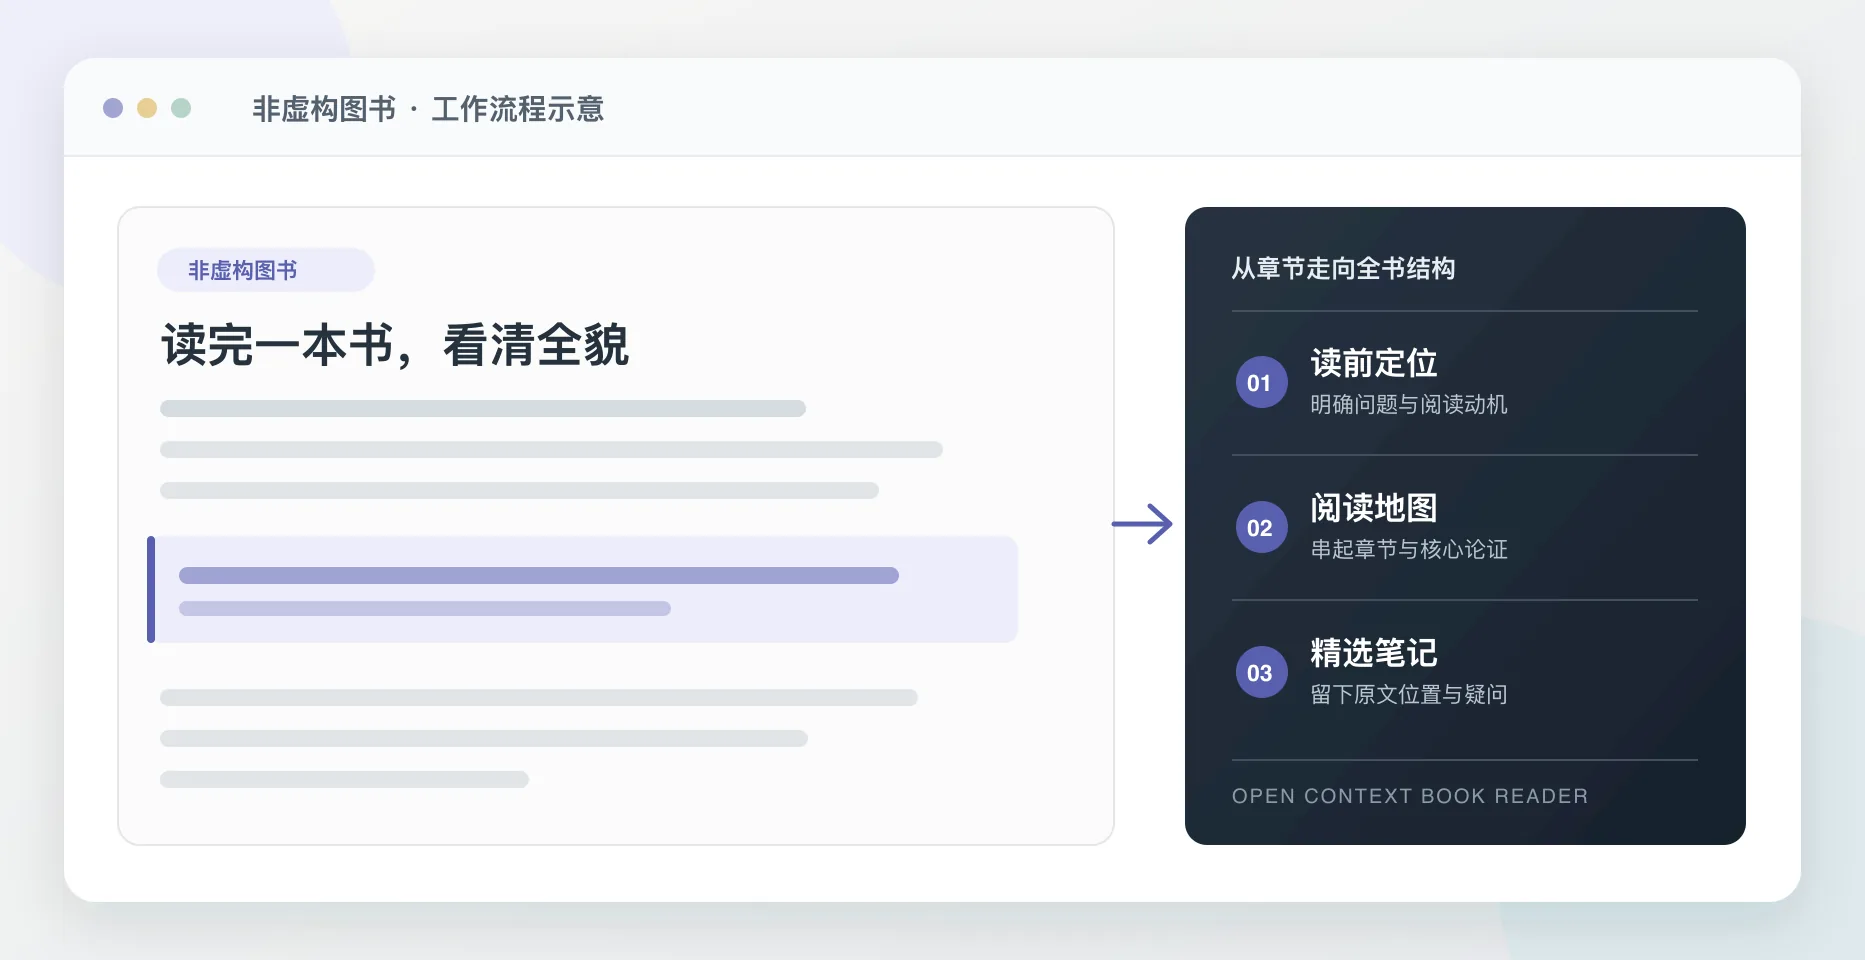
01
读前定位
梳理作者、背景、领域、核心问题和适合的读者,让阅读目标更清楚。
02
阅读地图
说明各部分如何推进全书的问题、框架和论证,而不是只复述目录。
03
可回查的笔记
精选笔记保留原书位置,区分作者观点、读者理解、质疑和待查证点。
03 / 使用
从本地图书或目录开始
将整个仓库加入 Agent 的 Skill 搜索路径,或让 Agent 先读取仓库根目录的 SKILL.md。提供图书文件、目录或导出的划线笔记,并说明希望先定位还是做读后分析。例如:
使用 $open-context-book-reader 阅读:〈本地图书文件路径〉 请先检查文本提取质量和实际读取的章节,再按以下顺序回答: 1. 读前定位:说明本书的核心问题、适合的读者和阅读重点。 2. 阅读地图:解释各部分如何推进全书的框架与论证。 3. 精选笔记:整理关键观点,标注章节或原文位置,并区分作者观点、你的理解与待查证问题。 若只能读取目录或部分章节,请标明覆盖范围,不将局部分析写成全书结论。
当前状态
GitHub 仓库已公开,采用 MIT 协议。仓库提供本地提取脚本;生成的提取包可能包含图书全文,应保存在自己指定的仓库外目录。扫描版和复杂图表仍需要人工核查。
查看源码与使用说明