Chrome 扩展 · 本地优先
Open Context Clipper
文脉采集器
把网页文章带回自己的本地知识库。预览、保存、整理,再按需导出为 Markdown。
01 / 预览
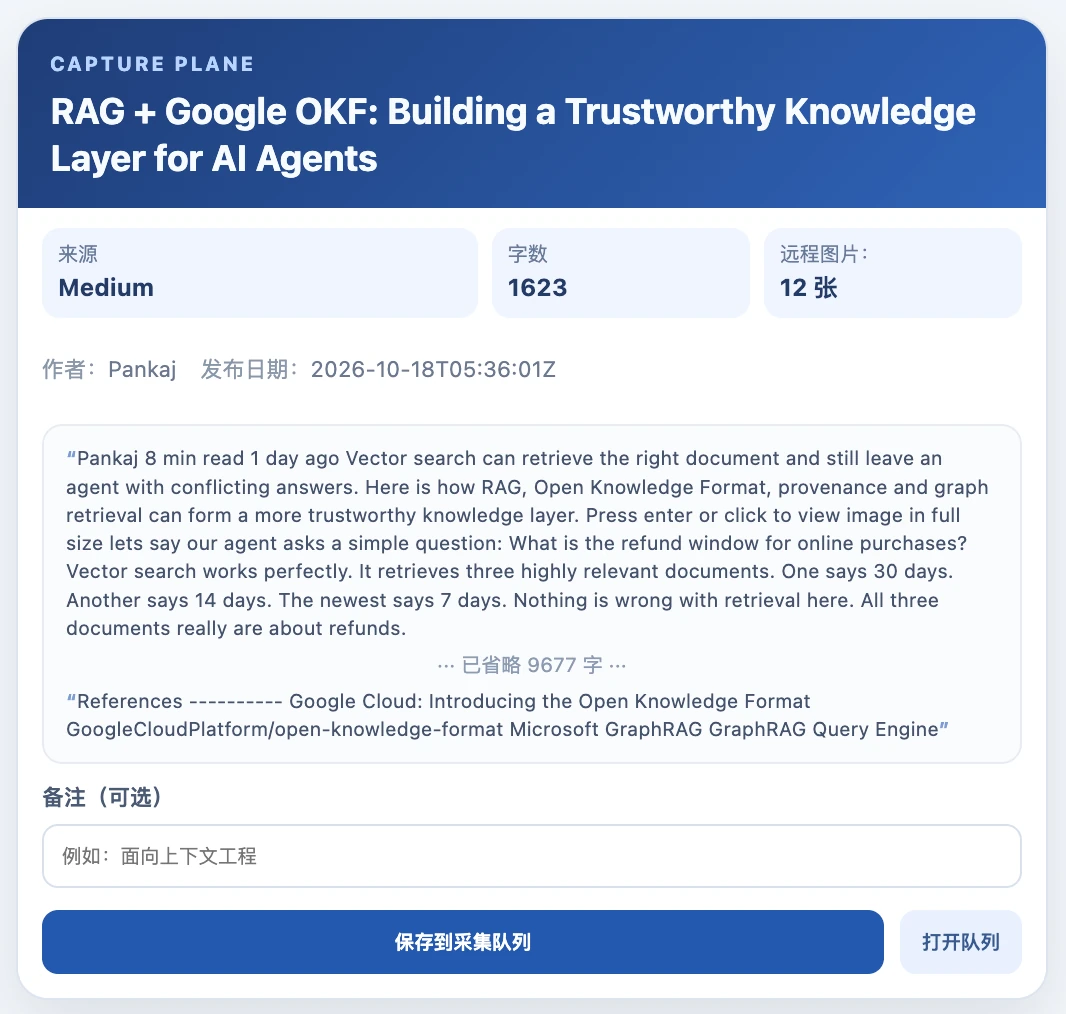
先看内容,再决定保存
扩展会展示识别出的标题、来源、正文片段等信息。只有点击“保存到采集队列”,文章才会留在本机;关闭弹窗不会自动保存。
02 / 整理
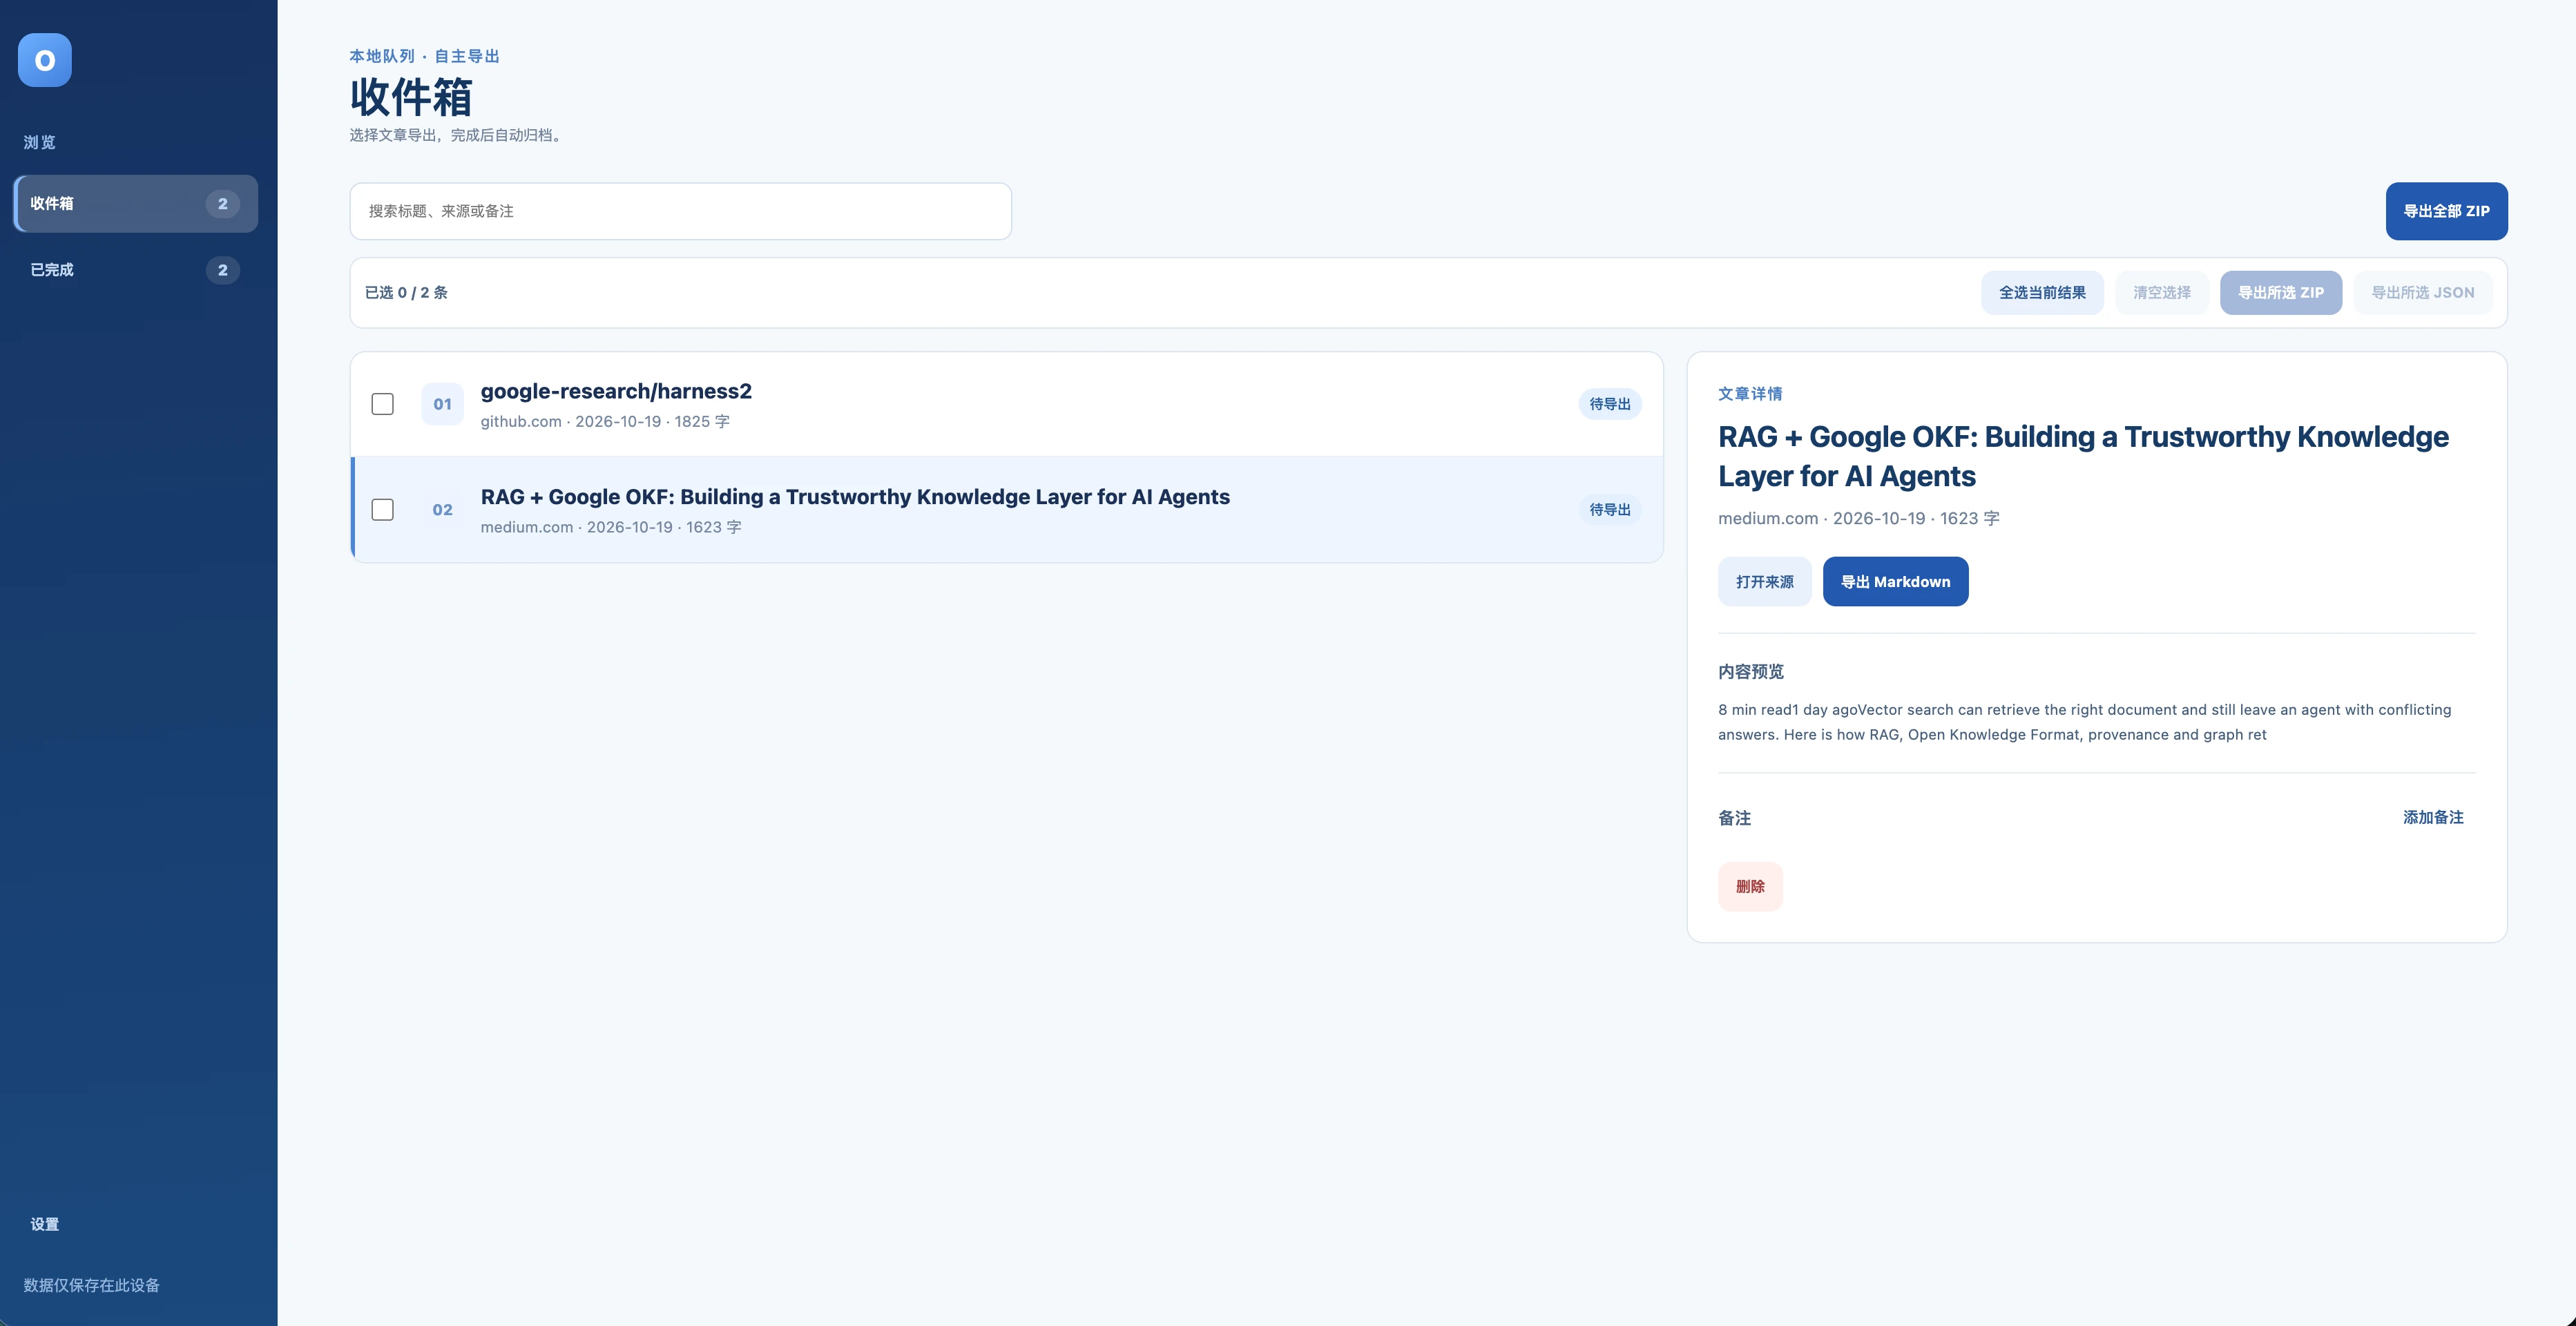
在本地队列集中管理
已采集的文章可以搜索、查看详情、添加备注和批量选择。待导出的内容放在收件箱,导出开始后进入“已完成”,便于近期查找和再次导出。
03 / 导出
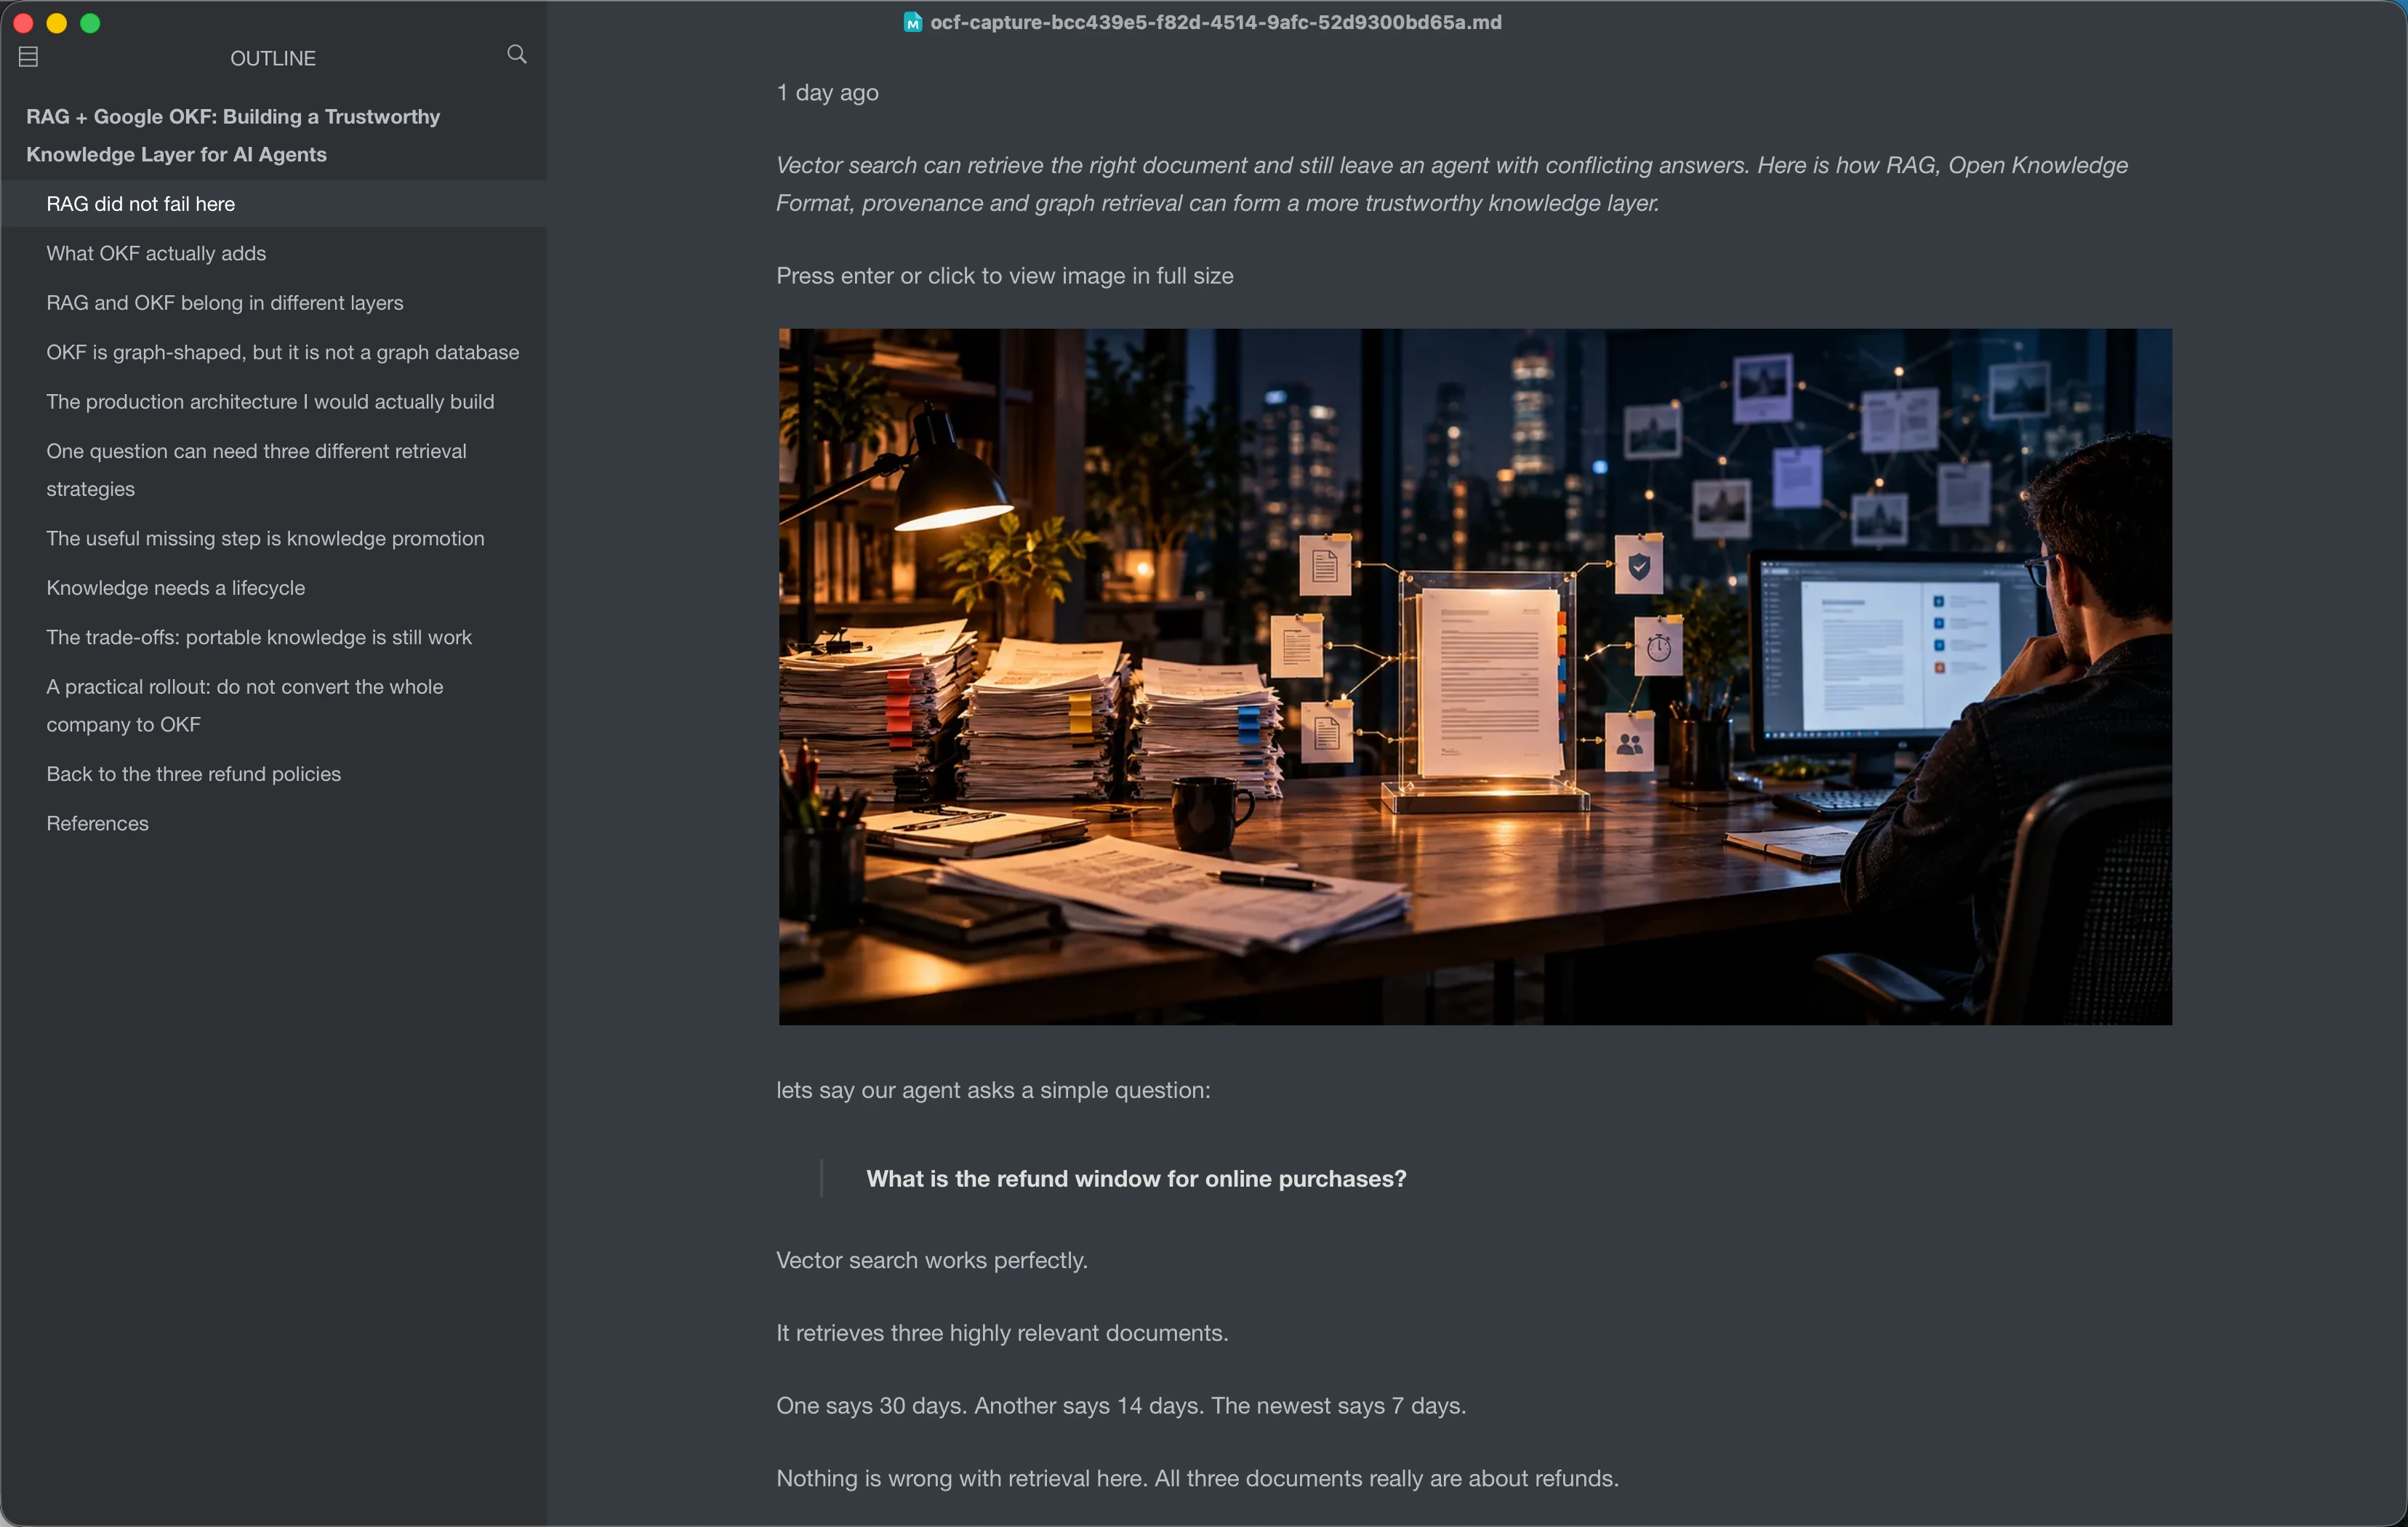
继续用熟悉的工具阅读
单篇文章可以下载为 Markdown;多篇文章可以打包为 ZIP,也可以导出所选记录的 JSON。Markdown 保留来源等信息,是可以自行整理和备份的普通文本文件。
当前状态
Open Context Clipper 已在 GitHub 开源,目前仍需按照仓库说明从源码构建,并在 Chrome 中加载已解压的扩展程序;尚未上架 Chrome Web Store。文章提取、队列保存和转换都在浏览器本机完成,无需账号或后端服务。
查看源码与安装说明