
- 发布日期
动态工作流:让 Agent 编写计划,让代码负责执行
- 作者
- 姓名
- Shoukai Huang
- 身份
- Software Architect · Indie Developer
审计大型代码库时,可以让一个 Agent 从头读到尾,也可以由 Lead Agent 分派任务、收集助手报告。单个 Agent 可能在读完前停下;由 Lead 逐个调度,则会把调度工作和上下文压力留在 Lead 身上。预先编写并行流水线可以减轻这两类负担,但工程师仍要事先定好扫描轮数、复核方式和停止条件。
Fareed Khan 在《Building Dynamic Workflows: A New Agentic System》中展示了一种动态工作流:文章的核心判断是:Lead 根据任务摘要生成短程序,普通代码随后检查、预演、审批并执行它。模型选择策略,运行时负责受控执行。 并发、预算和过程记录由运行时统一管理。Plan-as-Code(计划即代码)指的就是把计划写成程序。
在作者的代码审计实验中,这种设计找回了更多植入缺陷,成本也更高。下文结合程序流程和实验数据分析这项取舍;机制与数字均来自原文及其代码、记录,本文未独立复现实验。
1. 从一页事实到一段计划
作者的任务是检查一个包含 849 个 Python 文件、约 134.8 万个带行号 token 的公开代码库。Lead 不直接阅读这些代码,而是先接收由普通代码生成的一页事实摘要:文件数量、输入规模、分片参数、调用价格、并发限制和任务预算,约 500 个 token。
这里的分片(shard),就是一次交给一个扫描 worker 阅读的一组文件。Lead 根据摘要决定如何组织这些 worker,例如扫描多少轮、每轮关注什么问题、怎样复核候选发现。
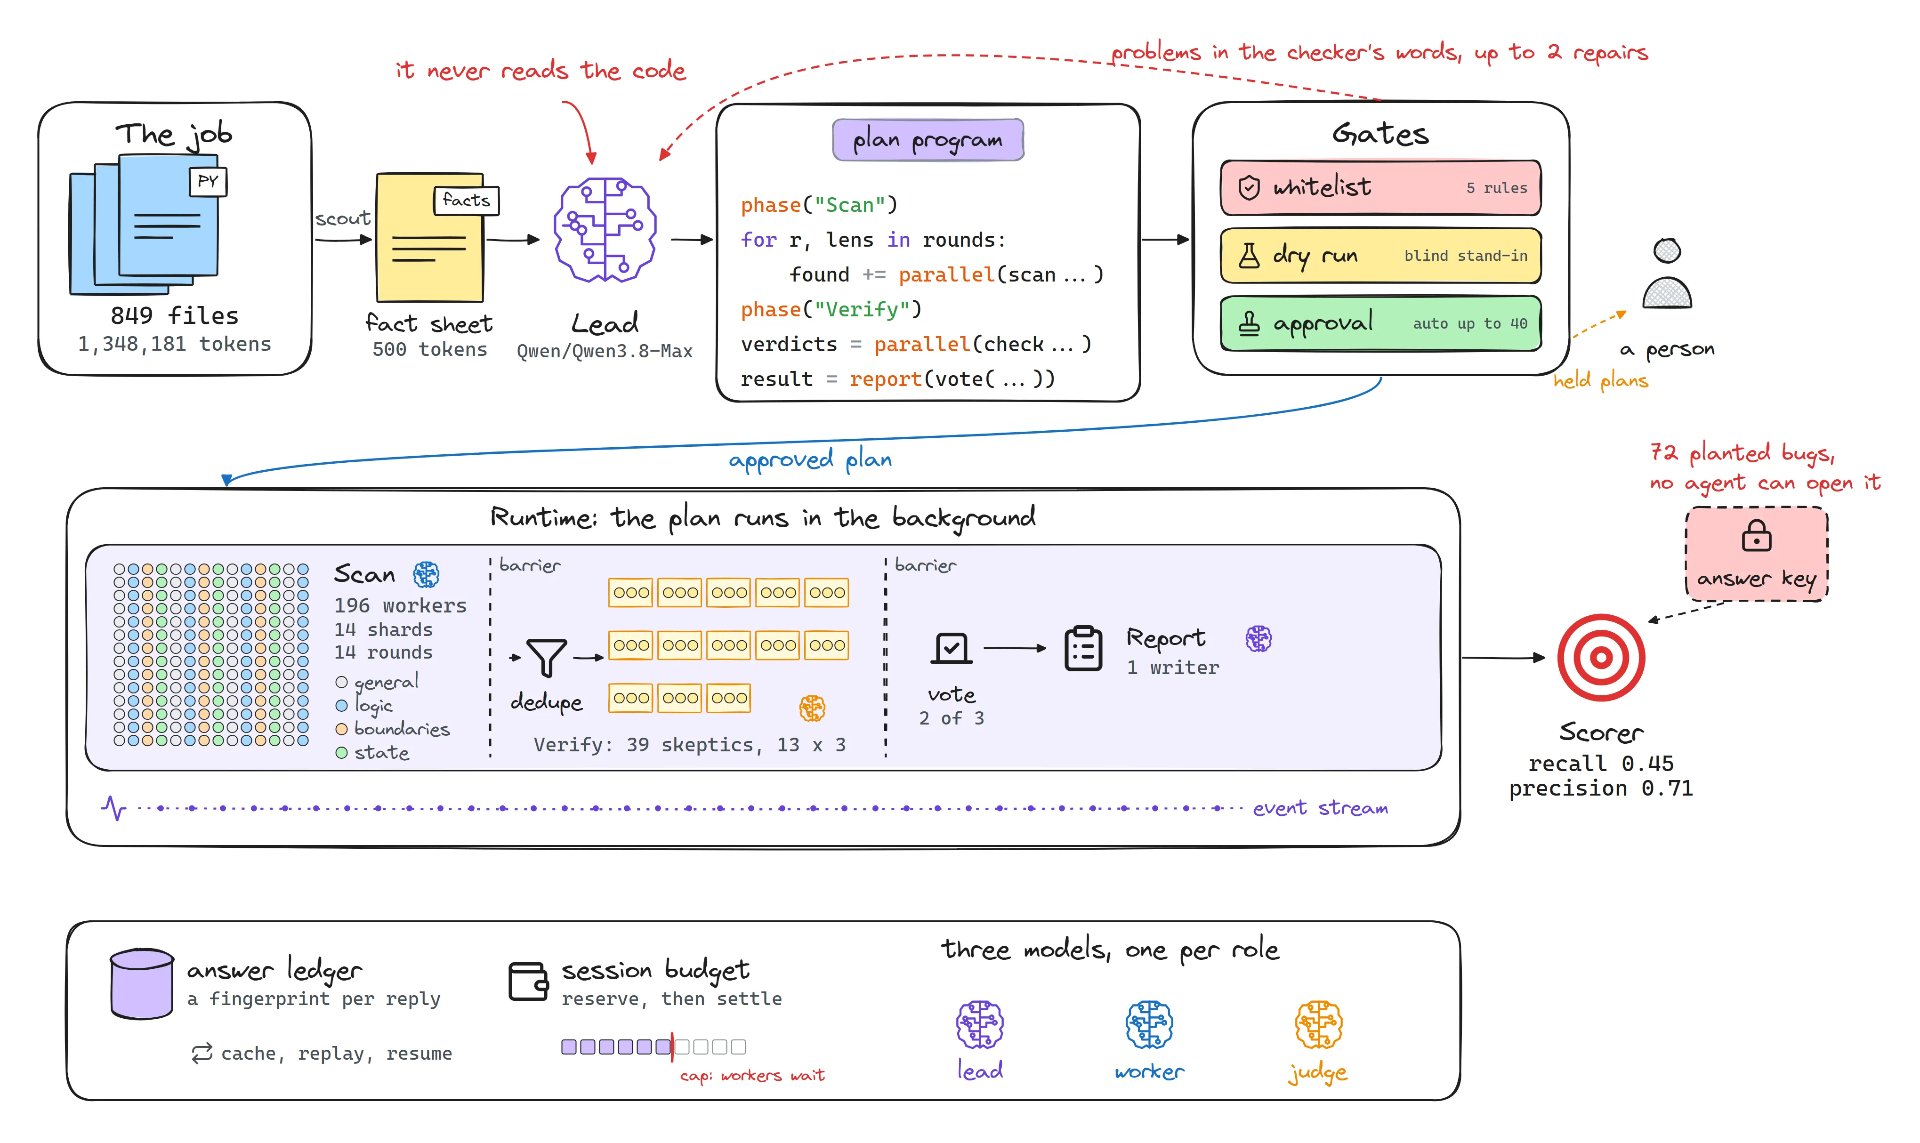
图 1:Fareed Khan 原图,动态工作流结构示意,非本文本地运行截图。原图来源:完整图片 URL。图内模型名称属于原文配置,本文未验证其可用性或效果。
图中 Scan 的 196 workers 对应“14 个分片 × 14 轮”的结构;右侧 recall 0.45、precision 0.71 是动态设计的实验均值。原文另在一次主付费会话的耗时分析中记录 193 次 scan calls,这是不同的统计口径。输出修正可能让一个 worker 多次调用模型,因此 worker 数不能代表模型调用总数。
工作流依次经过 Scout、Plan、Check、Rehearse、Approve、Run 六个阶段。计划检查通过后才进入正式执行。Plan 阶段的 Lead 已经调用真实模型,因此生成和修复计划会产生费用。 代码生成的事实页和使用替身模型的预演不收费;这不代表审批前的整个流程免费。
2. 六个阶段分别做什么
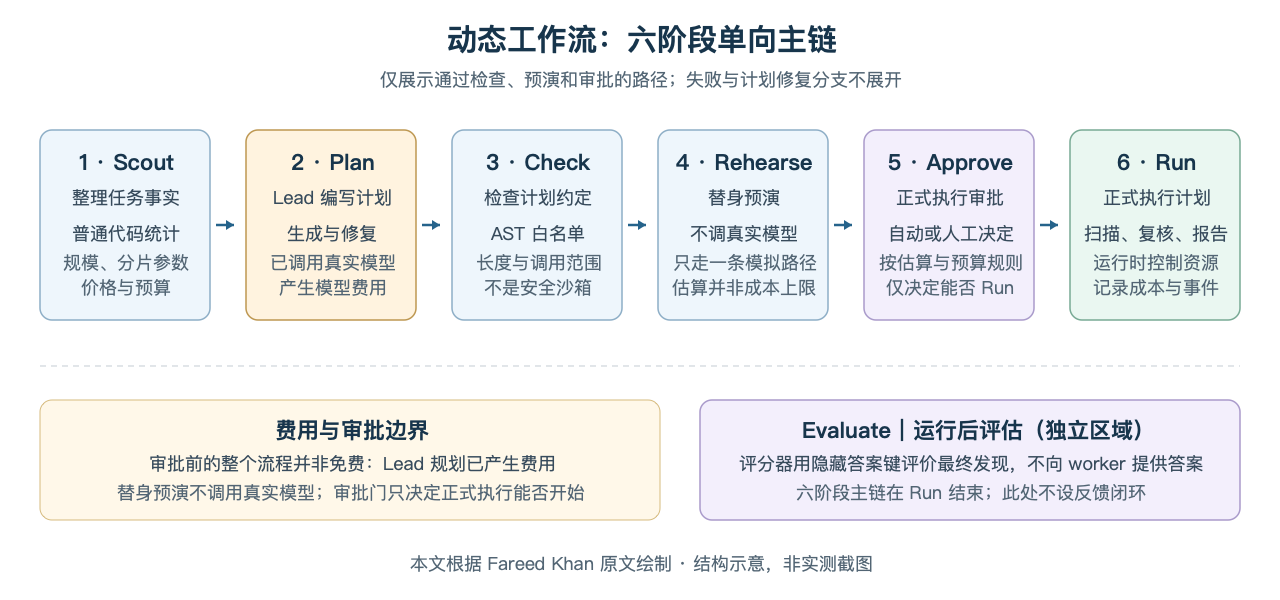
图 2:本文根据 Fareed Khan 原文绘制,结构示意,非实测截图。主链单向依次经过六阶段,Evaluate 单独表示运行后评估;Lead 规划已调用付费模型,替身预演不调用真实模型,审批只针对正式执行。
2.1 Scout:整理任务事实
Scout 用普通代码统计输入并生成事实页,Lead 因而不必先读完整个代码库,规划所需的上下文也随之减少。事实页中的参数会影响后续计划;这些参数来自一次测量,未必适用于其他任务。
分片参数的选择也出现了反差。作者先用 283 个文件和 24 个植入缺陷测试分片大小,并按预定规则“召回率距最好结果不超过 0.05 时选最大分片”选出 100k token。随后,全系统的精简计划测试中,20k 分片召回率为 0.38,100k 为 0.18。五设计比较仍统一使用 100k;这组局部测试没有证明 100k 是全局最优值。
2.2 Plan:让 Lead 写出候选程序
Lead 可以调用预先提供的 scan、check、report 等能力,用条件和循环描述执行策略。程序能够表达“再扫描一轮,如果新增发现很少就停止”,也能读取 budget() 后缩减工作量。
计划可以读取预算并调整工作量,但模型未必会这样做。原文生成的 10 个计划中,6 个首次通过检查,其余 4 个超过 80 行限制,经一次修复后通过。10 个计划都有循环和依赖结果的决策,只有 1 个读取了 budget()。
生成器最多修复计划两次,即首次生成后最多再尝试两轮。每轮检查或预演发现的问题都会反馈给 Lead。
2.3 Check:检查程序是否符合约定
Check 先解析 Python 的抽象语法树(AST),再检查程序长度、允许的语法、名称和方法调用范围。原文的上限是 80 行、6,000 字符,禁止 import、while 等结构,并要求出现对 result 的赋值。
AST 检查只确认程序中出现了对 result 的赋值,没有检查每条执行路径是否都会赋值。禁用 while 也无法保证循环及时结束,for 仍可能迭代很多次。原文有一个请求百万个 worker 的程序通过静态检查,之后才被预演的 worker 上限拦下。
作者说明,白名单面向自有 Lead 生成的受限计划语言,不是安全隔离边界。若要运行外部不可信代码,还需另行设计隔离、权限和资源控制;AST 检查本身不是安全沙箱。
2.4 Rehearse:用替身跑一条模拟路径
预演(dry run)用免费的替身模型生成虚构的发现和复核意见,让计划走过一条模拟路径,再按原文配置的调用价格估算 worker 数、调用数和 credits。它能暴露异常规模及部分运行问题,不评估审计质量。
一次预演只走一条模拟路径,不能覆盖所有分支,也不能给出成本上限。 真实扫描产生的候选数量会改变复核批次数;输出不合规也会增加调用。原文固定计划的预估为 10.1 credits,三次真实运行均值为 13.8 credits,预估低约 27%。这里的 credits 是作者系统的计量单位,不是现实货币金额。
预演应使用与真实运行相同的预算输入,因为计划可能据此选择不同分支。原文结尾建议先用一次真实运行校准替身模型,并为 Lead 的循环设定停止条件。
2.5 Approve:按事先规定的规则放行
审批门使用预演估算值。原文自动批准上限是 min(40 credits, 总预算的三分之一):估算不超过上限就自动放行;超过自动上限但没有超过总预算,则等待人工决定;超过总预算就拒绝。
作者展示的动态计划估算为 52.9 credits,任务预算为 150 credits,超过自动批准上限。作者按预先设定的“低于预算一半即可批准”规则同意执行。审批门决定计划能否开始,实际运行仍由预算机制控制用量。
2.6 Run:执行已获批准的计划
运行时启动扫描、复核和报告 worker。它记录每个 worker 的对话、所属阶段、回复、状态、耗时、成本和错误,并输出阶段与任务事件。
parallel 接收一组无参数任务,并发运行并等待全部完成后再进入下一步,因此较快的任务也要等最慢的任务。原文一次固定计划的扫描阶段记录到,已完成的 worker 合计等待了 37 个 worker-minutes。
3. 一个完整的审计例子
把运行过程展开,链路是:扫描 → 合并重复发现 → 怀疑者复核 → 投票 → 报告。
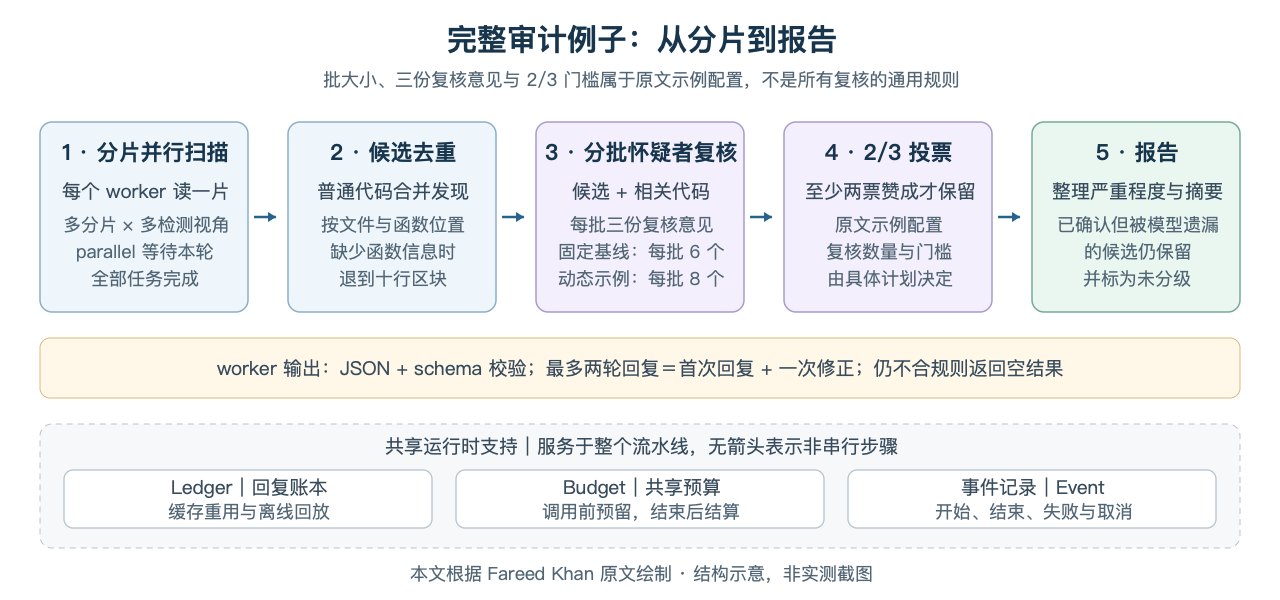
图 3:本文根据 Fareed Khan 原文绘制。
扫描 worker 每次读取一个分片,从边界条件、逻辑、状态等不同视角找问题。输出包含文件、行号、问题描述,还可以给出能触发问题的调用。多个 worker 可能报告同一处,因此普通代码先按文件与函数位置去重;没有函数信息时,退到文件中的十行区块。
去重后的候选分批交给 skeptic(质疑者)复核。复核者查看候选描述和相关代码,并在证据不足时否定发现。原文固定基线对每批候选收集三份意见,至少两票赞成才予以保留。报告模型再整理严重程度和摘要;示例实现也会保留未被报告模型列出的已确认候选,并标为未分级。
下面是原文固定基线的核心程序,用来说明各步怎样连接;它依赖作者提供的审计工具和运行时:
phase("Scan")
found = flatten(parallel([
    lambda s=s, lens=lens: scan(s, lens)
    for s in shards(100000) for lens in LENSES
]))
candidates = dedupe(found)
phase("Verify")
verdicts = flatten(parallel([
    lambda b=b, k=k: check(b, sample=k)
    for b in batches(candidates, 6) for k in range(3)
]))
confirmed = vote(candidates, verdicts, need=2)
phase("Report")
result = report(confirmed)
动态计划可以改变扫描轮次、检测视角、批大小和停止条件。原文展示的一个计划选择了 14 轮扫描,轮换 general、logic、boundaries、state 等视角,再按每批 8 个候选、三份复核意见和两票门槛生成报告。Lead 提交的是整体策略,执行时由代码组织并行任务,不必每完成一个 worker 就回到 Lead 重新分派。
worker 输出还要经过 JSON 解析和 schema 校验。原文 _converse 的 range(2) 表示最多两轮模型回复:首轮出错后反馈问题,模型再修正一次。若第二轮仍不合规,worker 就失败并返回空结果,运行时会记录错误。
文章逐步搭建的示例 build 省略了原始实验中的失败调用重试,也没有把沙箱执行结果展示给 skeptic。示例代码用于解释架构,实验记录则来自原始运行,二者并非同一套完整实现。
4. 运行时怎样约束成本并保留证据
计划决定任务如何展开;运行时记录每次调用,并统一管理资源。
| 设施 | 在这套实现中的作用 | 实现范围 |
|---|---|---|
| Answer Ledger(回复账本) | 按请求指纹保存回复;支持缓存重用和离线回放 | 缓存命中可以少调用,但不保证并发请求只执行一次 |
| Budget(预算) | 调用前预留额度,结束后结算;额度不足时等待上限调整 | 原文按调用计固定 credits,不按通用 token 账单计费 |
| Thread 与 Phase | 保存 worker 对话并标记扫描、复核、报告等阶段 | worker 数与调用数可能不同 |
| Parallel 与 worker 上限 | 管理并行执行,拒绝过量 worker,并对失控请求触发取消 | 同步屏障会等待慢任务;不保证所有代码终止 |
| Event Stream(事件流) | 记录开始、结束、失败、取消等过程 | 有助于追踪,不自动构成持久化的进程恢复机制 |
| Scorer(评分器) | 在实验中用隐藏答案键给最终发现评分 | 这是事后评测,不把答案提供给扫描或复核模型 |
Ledger 的指纹包括模型、消息、调用参数和 sample index。同一问题使用不同 sample index,会被当作独立采样;同一指纹已有回复时,则读取缓存。replay 模式遇到没有保存的问题会报 CacheMiss,不会偷偷访问网络。
作者用假客户端演示取消后重跑:计划共需 60 次调用,首轮取消前完成的 30 次进入缓存,第二轮只新增 30 次。这个例子展示了重跑时复用已完成回复。代码把缓存查询、网络调用和写回分开处理,也没有合并相同指纹的并发请求,因此不保证 exactly once(恰好执行一次)。若模型已返回、回复尚未写入账本时发生故障,重试仍可能再次付费。
恢复时需要重新运行计划并由账本返回已缓存回复;它没有从任意程序位置续跑的进程级 checkpoint。示例通过协作式标记取消任务,已发出的网络请求不一定立即中止。
共享计量表让多个 worker 共用同一额度:调用前预留,结束后结算,额度不足时暂停等待。正式审计运行使用新建的 Budget,worker 统计不含此前 Lead 生成和修复计划的费用;比较总成本时要分别核对这两部分。
5. 实验结果应该怎样读
5.1 先看它在测什么
作者在 849 个文件中,分别向 72 个文件植入一个缺陷。每个缺陷会使至少一个、且不超过该文件 40% 的 doctest 示例失败;Agent 读取的副本移除了这些示例。隐藏答案键由评分器使用,模型不能直接读取它。
命中要求是同一文件、同一函数,并落在缺陷行的前后五行范围内。recall(召回率)表示 72 个植入缺陷中找回了多少;precision(精确率)表示评分器认可的发现占比。评分器还会按位置合并未命中的报告,不能简单把重复文本都算成独立误报。
评分时,答案键之外的位置一律计为误报,即使其中可能存在未植入的真实问题。作者因此把报告的 precision 称为下界;实验没有独立确认这些额外发现,也不能据此估算真实代码审计的误报率。
5.2 五种设计:覆盖更多,也花得更多
五种设计使用同一隐藏答案键评分,作者报告如下:
| 设计 | 运行次数 | 平均 recall | 平均 precision | 平均 credits |
|---|---|---|---|---|
| A:单 Agent | 3 | 0.02 | 1.00 | 23.7 |
| A2:给单 Agent 与动态运行相当的预算 | 2 | 0.04 | 0.78 | 46.4 |
| B:Lead 加 helpers | 1 | 0.17 | 0.67 | 10.3 |
| C:手写固定计划 | 3 | 0.30 | 0.82 | 13.8 |
| D:动态工作流 | 3 | 0.45 | 0.71 | 48.4 |
**这一组实验的主要结果是:动态设计的平均召回率高于固定计划,平均成本约为其 3.5 倍,精确率较低。**单 Agent 获得更多预算后仍自行提前停止,召回率只从 0.02 增至 0.04。它的 precision 为 1.00,但只找回极少缺陷,不能单看精确率判断审计效果。
这组比较没有单独测出动态规划的贡献。动态计划扩大了扫描规模,也改变了策略;作者没有用同样扫描 14 轮的固定计划作对照,因此无法区分提升来自多轮扫描还是规划策略。
单次结果与表中均值也要分开看。作者展示的一次完整审计使用 236 个 worker、247 次调用、49.7 credits,找回 38 个植入缺陷,recall 为 0.53、precision 为 0.76。前述主付费会话的 193 次扫描调用来自另一段单次会话耗时分析。
5.3 消融实验:有用的组件也可能没达到预期
作者逐项移除组件,检查预设目标是否实现。第二轮扫描在三次运行中分别新增 5、6、2 个植入缺陷。两种工作流都读过全部文件;许多漏检是读到代码后没有报告问题,并非文件未被访问。
skeptic 复核的 precision 点估计提高 0.25。预设的 H4 要求提升至少 0.15,且 recall 最多下降 0.05;但 precision 提升区间下端为 0.13,recall 降幅可能达到 0.069。两项门槛都未能确认,结果不足以支持“无损改善”。
把候选的失败调用放进沙箱执行,并将结果交给 skeptic,没有支持 H6:带执行结果的得分为 0.84,不带时为 0.85。作者把检测视角、沙箱和跨代评审模型的消融结果归为中性。在一次运行的 40 个位置上,单个 skeptic 的 precision 比三个更高,recall 没有下降;样本太小,不能据此普遍改用单人复核。
作者预先提出的 11 项预测只有 3 项成立,动态运行的稳定性也没有优于单 Agent。各设计仅运行 1—3 次,测试范围限于一个代码库和一个模型族,区间较宽。未成立的预测同样留在原文中;这组结果适合作为架构实验参考,不能当作成熟方案的效果承诺。
6. 什么任务值得引入动态计划
本文的工程判断是:动态计划更适合输入规模大、子任务可并行、后续工作量随中间结果变化,并且需要控制成本、留存运行记录和评价结果的任务。 这一判断基于单个案例,仍须结合具体任务验证。
步骤稳定、输入较小时,固定流水线通常更易维护。若采用动态计划,可先固定工具接口和输出 schema,设置预算、账本、worker 上限并记录事件,再让 Lead 在受限程序中选择扫描轮次、批大小和停止条件。即使计划改变,运行记录仍可用于比较。
后续评估需要回答几个具体问题:预算和扫描规模相同时,动态计划能多找出多少问题?预演误差多大?复核收益能否抵偿额外调用?缓存遇到并发和故障时能保留哪些结果?这些数据将决定生成式计划是否适合长期运行。
来源
- Building Dynamic Workflows: A New Agentic System — Fareed Khan,2026 年 10 月 19 日。机制、代码和实验数字均为原文转述,非本文独立实测。
- Fareed Khan 动态工作流架构原图,正文采用用户提供的同图 JPG。