
- 发布日期
Foundry IQ 更会找资料了,为什么仍会答错?
- 作者
- 姓名
- Shoukai Huang
- 身份
- Software Architect · Indie Developer
“哪些服务属于 PCI 范围?”
PCI 是 Payment Card Industry(支付卡行业)的缩写。这里的“PCI 范围”,指需要按支付卡行业数据安全标准(PCI DSS)管理和检查的系统范围。
在 Miodrag Cekikj 的一次测试中,微软的 Foundry IQ 知识库服务找到了相关规则,也准确复述了规则,却没有列出任何服务。标准答案有五个。
这道错题出自《Microsoft’s Knowledge Layer, Measured》。在同一组测试里,普通 RAG 的问答得分为 58%,Foundry IQ 的 medium 档达到 78%。拆分问题、多轮搜索确实带来了提升,但有些工作仍没完成:记录要逐条统计,依赖要沿关系追踪,规则要应用到具体服务上。
多轮检索值得用。但需要精确结果的业务问答,还得检查拿到了哪些记录,以及怎样从这些记录得出答案。
58% 到 78%,测的是什么
Foundry IQ 是微软提供、基于 Azure AI Search 的知识库服务,帮助 AI 从企业资料中寻找回答依据。
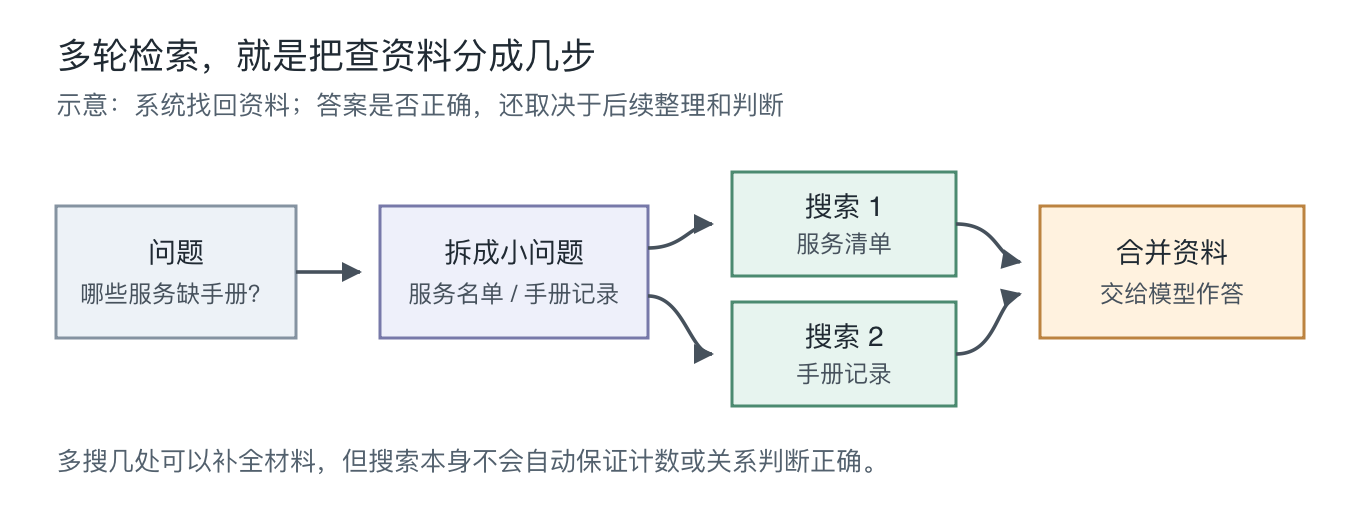
普通 RAG(检索增强生成)先搜索,再让模型根据材料作答。在这次测试中,Foundry IQ 的 low 档会由模型规划多个搜索,medium 档还允许在首轮材料不足时继续查找。
Cekikj 为一家虚构的支付公司准备了 105 份文档、108 个文本片段,设计了 32 道有标准答案的题。题目包括查找文字信息、统计事故、追踪依赖和按规则筛选服务。他还比较了一套结合检索与图查询的混合方案:用检索读取文档,用图查询处理实体之间的关系。
| 方案 | 在这组题上的问答得分 |
|---|---|
| 普通单轮 RAG | 58% |
| Foundry IQ:minimal(单轮搜索,无模型规划) | 62% |
| Foundry IQ:low(模型规划多个搜索) | 72% |
| Foundry IQ:medium(允许继续检索) | 78% |
| 作者的混合方案(检索与图查询结合) | 91% |
这些百分比是最终回答的评测得分,不是检索准确率,也不能直接换算成答对了多少道题。材料是否找齐、模型如何利用材料,都会影响成绩。
medium 比普通 RAG 高出 20 个百分点。具体案例则能解释,这些提升来自哪里,还有哪些错误没有解决。
资料找齐了,缺项才找得出来
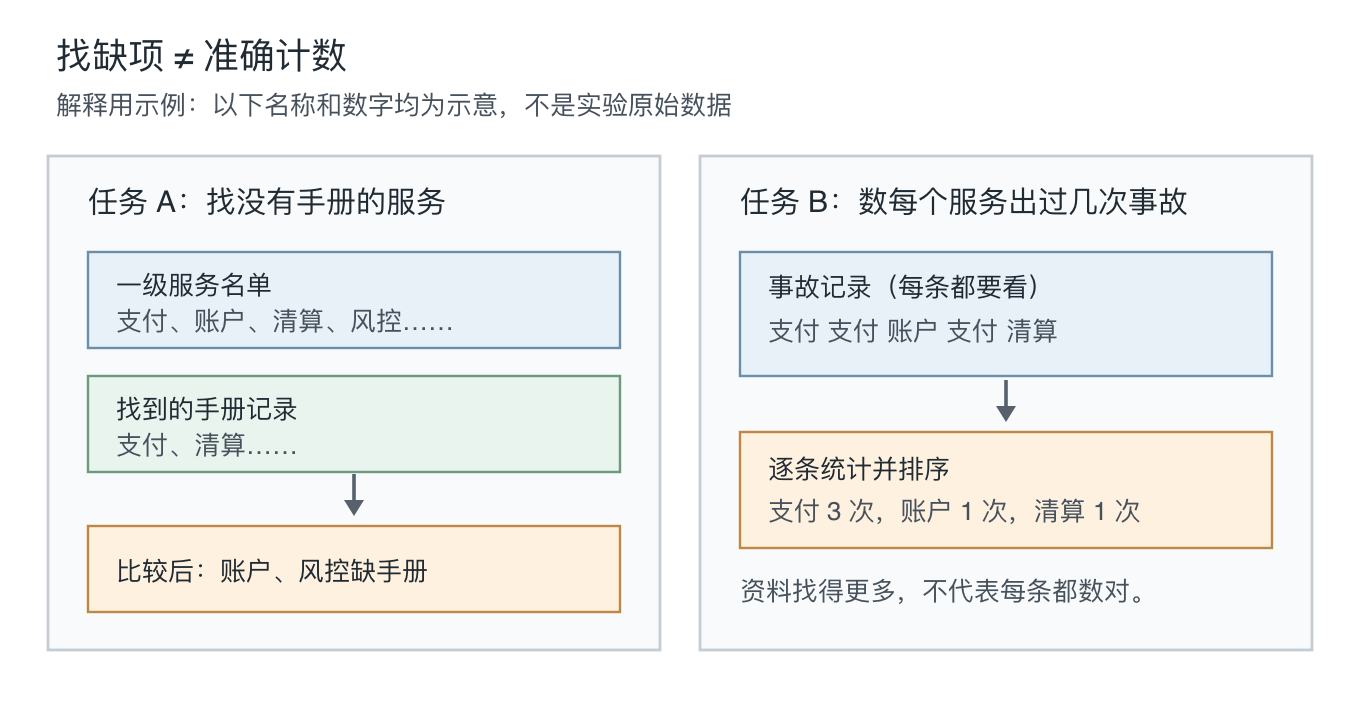
“哪些一级服务没有操作手册?”是一道多轮检索表现不错的题。
直接搜索“没有手册的服务”容易漏项。服务文档通常记录已有的配置和操作,不会专门写一句“本服务没有手册”。要查清楚,得先拿到全部一级服务的名单,再逐一核对手册记录。
原文报告,low 档只列出了三个缺项中的一个。medium 档把相关的 12 个服务页面都放进上下文后,找出了全部三个。
多搜几轮补齐了材料,模型随后完成了名单比较。这个例子也有明确前提:核查范围得完整。如果连服务名单都没拿齐,就无法可靠地判断谁缺了手册。
规则找到了,还得逐项执行
回到开头的 PCI 题。
题目给出的规则是:服务如果接触持卡人数据存储,或者直接调用了这样的服务,就在范围内。文档写了规则,却没有列出最终名单。这是测试题的简化设定,实际系统的 PCI DSS 范围需要另行评估。
要得到名单,系统得先查出哪些存储保存持卡人数据,再找到接触这些存储的服务,最后查出直接调用这些服务的其他服务。
Foundry IQ 完整复述了规则,但 low 和 medium 两档都没有列出任何服务。用户要的是名单,回答停在了解释规则这一步。接下来需要检查服务和存储之间的关系;多返回几遍规则本身,仍然得不到名单。
依赖追踪也有类似情况。原文的一道故障影响题需要沿关系追踪四跳,也就是顺着依赖连续查四层。medium 找到了更多服务页面,仍漏掉两个下游服务。相关页面搜到了多少,并不能说明所有依赖都查过了。
事故统计则同时涉及材料和计算。“受事故影响次数最多的三个服务,各受影响几次?”medium 给出的次数是 6、6、4,标准答案是 7、5、4。
这道题不能简单归结为模型数错了。原文说明,系统拿到了大部分复盘记录,但没有拿齐。少了记录,统计就缺少完整依据;即使记录齐全,也还要统一口径、去重、逐条计数。检查答案时,这两步都不能省。
把需要计算的步骤单独做出来
这些题可以用来检查企业问答的处理流程。答案已经写在文档里时,重点是找到原文并准确引用;答案需要从多条记录中得出时,还要检查统计、筛选和关系追踪是怎样执行的。
| 业务问题 | 系统要做的事 | 要检查的地方 |
|---|---|---|
| 操作手册在哪里?保留期限是多少? | 找到并读取相关文字 | 引用是否支持答案 |
| 哪些服务缺少手册? | 拿到完整名单,逐项核查 | 名单是否齐全,怎样判定缺失 |
| 哪个服务事故最多? | 汇总记录,统计并排序 | 记录是否齐全,去重和计数是否正确 |
| 数据库故障影响哪些服务? | 沿依赖关系逐步追踪 | 方向、分支和终止条件是否正确 |
| 哪些服务符合某项合规规则? | 按规则筛选实体和关系 | 每个条件是否实际执行 |
统计和关系查询可以交给数据库、图查询、代码或业务函数。选哪种取决于数据存在哪里、关系怎么表达。无论用什么,都应能复查读了哪些记录、用了哪些条件、怎样得到最终结果。接入工具之后,数据和查询本身仍要校验。
作者的混合方案采用了这样的分工,最终得分为 91%。但它也有短板:恢复时间目标、数据保留期限等信息只写在文档里,没有录入关系图。在这类五道文字事实题上,Foundry IQ 得分为 80%,高于混合方案。关系图里没有的事实,仍要回到文档中找。这个结果支持按任务组合使用检索和查询,不能据此认定图查询全面优于检索。
搜索强度也有成本。按作者的估算,low 到 medium 每题成本从约 1.5 美分增至 2 美分,得分从 72% 升到 78%,延迟也增加了。这是当时的实验成本,不代表当前报价。如果错题卡在规则没执行、依赖没查完,继续增加搜索次数未必划算。
用错题检查系统
这组结果来自一家虚构公司的资料,只有 32 道题,每类样本都很少。作者使用同一模型和评审方式,部分基线在不同日期运行。本文没有独立复现实验,也没有核验当前产品功能和价格。企业权限、治理、多来源接入等能力不在这次测试范围内。
78% 因而不能当作 Foundry IQ 在其他企业里的预期成绩,也不能用来判断它的性能上限。
更适合借用的是检查错题的方法:名单漏了,查核查范围和检索记录;统计错了,查数据覆盖、去重和计数;合规名单没给出来,查规则是否转成了实际筛选步骤。先确定漏了哪一步,再决定补检索、改查询还是调整程序。
开头那道 PCI 题,规则已经找到了。剩下要做的,是把五个服务查出来。
来源:Miodrag Cekikj,《Microsoft’s Knowledge Layer, Measured》,AI Advances,2026-10-22。原文。实验数据、产品行为和混合方案成绩均为原文作者报告,本文未独立复现。